Những Con Số Vàng Mọi Kỹ Sư Thiết Kế Hệ Thống Phải Biết 2026
Khi Bạn “Đứng Hình” Trong Buổi Meeting Kiến Trúc
Hãy tưởng tượng cảnh này: Bạn đang ngồi trong buổi phỏng vấn System Design tại một công ty công nghệ lớn, hoặc đang họp với team về kiến trúc cho tính năng mới. Người phỏng vấn — hoặc CTO của bạn — quay sang hỏi: “Với 10 triệu người dùng, chúng ta cần bao nhiêu server? Cache cần bao nhiêu RAM? Băng thông sẽ là bao nhiêu?”
Và bạn… đứng hình.
Không phải vì bạn không giỏi. Mà vì không ai dạy bạn rằng có một bộ con số nền tảng mà mọi kỹ sư thiết kế hệ thống đều phải nằm lòng — và một framework có thể giúp bạn trả lời những câu hỏi đó trong vòng 10 phút, ngay trên tờ giấy trắng.
Đây chính là sức mạnh của back-of-the-envelope estimation — kỹ thuật ước tính sơ bộ mà Jeff Dean, Peter Norvig và những kỹ sư hàng đầu tại Google đã sử dụng hàng thập kỷ qua. Trong kỷ nguyên 2026, khi các hệ thống phân tán ngày càng phức tạp và quy mô ngày càng lớn, bộ kỹ năng này không còn là “nice to have” — nó là điều kiện bắt buộc để trở thành một kỹ sư giỏi thực sự.
Tại Sao Những Con Số Này Quan Trọng Hơn Bao Giờ Hết
Trong các vòng phỏng vấn Senior và Staff Engineer tại Google, Meta, Amazon, Netflix — và ngày càng nhiều công ty công nghệ lớn tại Đông Nam Á như Sea Group, Grab, VNG — System Design là vòng sàng lọc quyết định. Và một trong những điểm phân biệt rõ nhất giữa ứng viên trung bình và ứng viên xuất sắc chính là khả năng đưa ra con số cụ thể, có căn cứ, trong thời gian ngắn.
Nhưng giá trị của những con số này vượt xa phỏng vấn. Ở cấp độ thực chiến, chúng giúp bạn:
- Tránh over-engineering: Đừng build Kafka + microservices cho hệ thống 1.000 người dùng khi một monolith PostgreSQL là đủ.
- Tránh under-engineering: Đừng deploy monolith không có cache cho hệ thống 100 triệu người dùng rồi phát hiện bottleneck khi đã lên production.
- Ra quyết định kiến trúc nhanh: Không cần benchmark thực tế, bạn đã biết Redis hay PostgreSQL phù hợp hơn cho use case của mình.
- Thuyết phục stakeholder: Khi bạn nói “chúng ta cần thêm 3 server và 64GB RAM cache để đạt SLA 99.9%”, đó là lập luận có số liệu — không phải cảm tính.
Latency Numbers: Bảng Tốc Độ Bạn Phải Thuộc Lòng
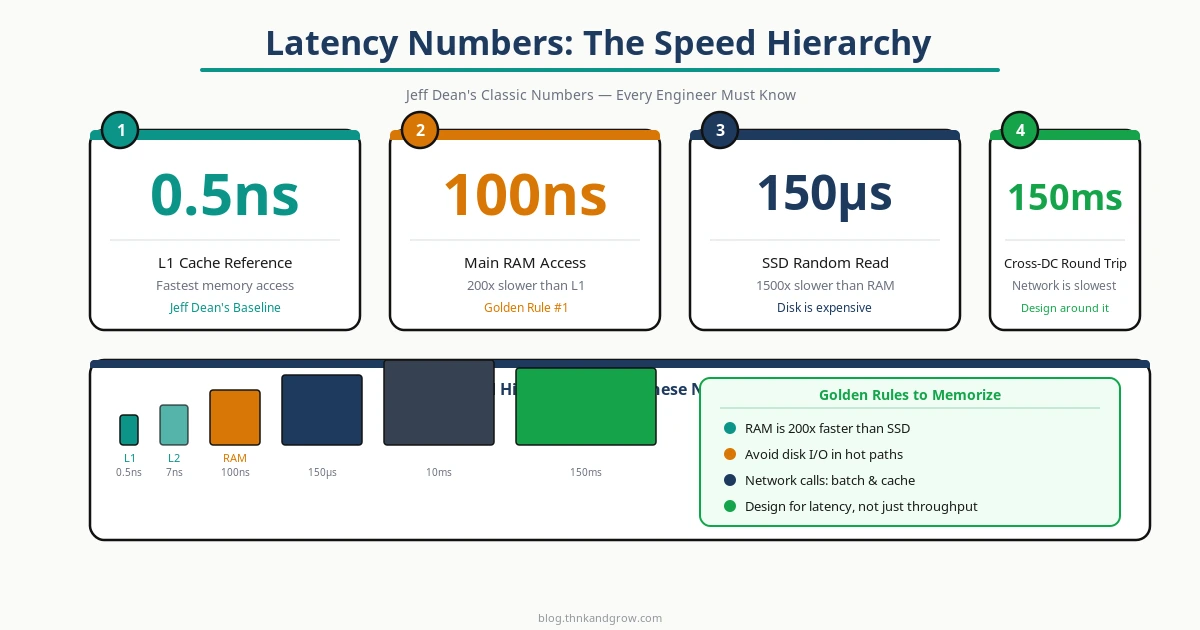
Mọi thứ bắt đầu từ bảng latency kinh điển của Jeff Dean — người đã định hình cách Google xây dựng hệ thống phân tán. Đây là bảng tham chiếu chuẩn mà mọi kỹ sư cần có trong đầu:
L1 cache reference:              ~0.5 ns
L2 cache reference:              ~7 ns
RAM reference:                   ~100 ns
Read 4KB randomly from SSD:      ~150 µs
Round trip trong datacenter:     ~0.5 ms
Read 1MB từ SSD:                 ~200 µs
HDD seek:                        ~10 ms
Round trip California → EU:      ~150 ms
Nhìn vào bảng này, có ba quy tắc vàng bạn cần nhớ ngay:
- RAM nhanh hơn SSD khoảng 1.000 lần
- SSD nhanh hơn HDD khoảng 10 lần
- Network trong datacenter ~0.5ms; cross-continent ~150ms
Những con số này trả lời trực tiếp các câu hỏi kiến trúc quan trọng. Ví dụ: nếu một query PostgreSQL mất 5ms, và bạn cần phục vụ 10.000 request/giây, thì rõ ràng bạn cần caching — vì không có đủ thời gian để hit database mỗi lần. Hoặc nếu ai đó đề xuất một synchronous cross-region call trong critical path, bạn biết ngay rằng 150ms latency sẽ là vấn đề nghiêm trọng với user experience.
Nguyên tắc thực hành: Mỗi khi ai đó đề xuất một kiến trúc, hãy hỏi: “Latency của operation này là bao nhiêu?” Nếu câu trả lời vượt quá ngưỡng chấp nhận được của use case, kiến trúc đó cần xem xét lại.
Powers of Two: Phép Tính Nhanh Cho Storage
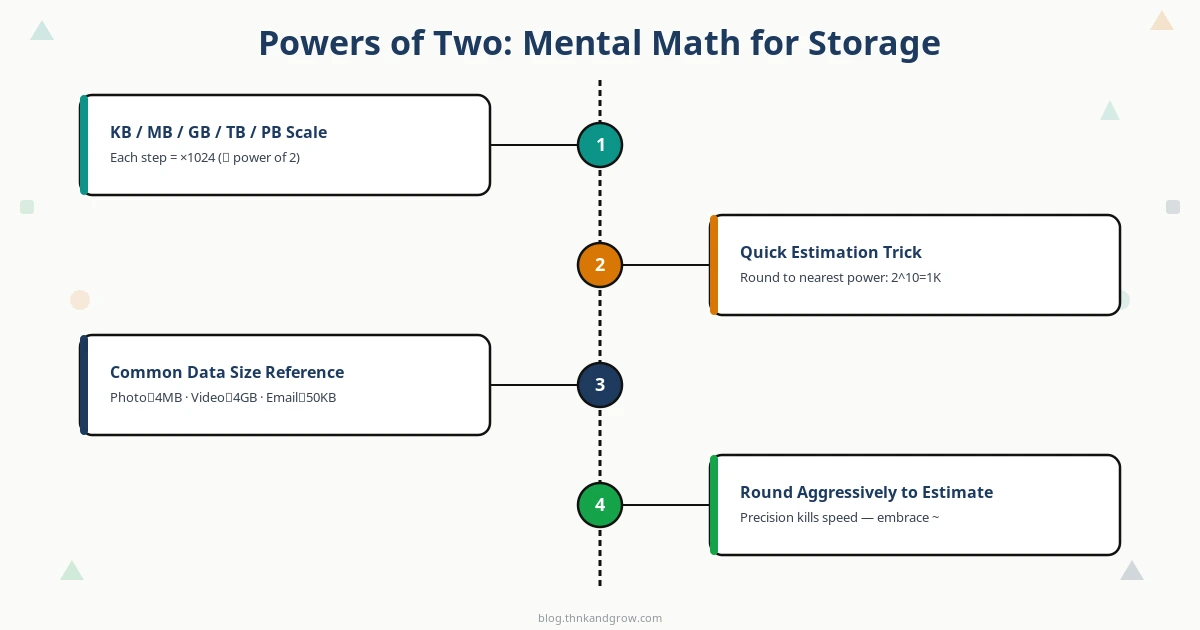
Khi ước tính storage, bạn cần làm bạn với lũy thừa của 2:
2^10  ≈ 1 nghìn     → 1 KB
2^20  ≈ 1 triệu     → 1 MB
2^30  ≈ 1 tỷ        → 1 GB
2^40  ≈ 1 nghìn tỷ  → 1 TB
2^50               → 1 PB
Kết hợp với kích thước dữ liệu chuẩn:
- Integer (int32): 4 bytes
- UUID: 16 bytes
- Một tweet trung bình: ~300 bytes
- Một ảnh trung bình: ~300 KB
- Video HD mỗi phút: ~100 MB
Ví dụ nhanh: Một hệ thống Twitter-like với 10 triệu DAU, mỗi người đăng 1 tweet/ngày → 10,000,000 × 300 bytes = 3 GB/ngày. Sau 5 năm: 3 GB × 365 × 5 ≈ 5.5 TB. Bạn vừa có con số để chọn storage solution trong vòng 30 giây.
Nguyên tắc quan trọng nhất: Làm tròn mạnh tay. Trong estimation, 300 MB hay 350 MB không quan trọng bằng việc bạn biết con số nằm ở mức “vài trăm MB” hay “vài chục GB”. Precision là kẻ thù của tốc độ trong bước này.
Availability Numbers: Hiểu Đúng Về “Số Chín”
Khi khách hàng yêu cầu “99.9% uptime”, bạn có biết điều đó có nghĩa là gì không?
99%      → 3.65 ngày downtime/năm
99.9%    → 8.77 giờ downtime/năm
99.99%   → 52.6 phút downtime/năm
99.999%  → 5.26 phút downtime/năm
Nhưng điều quan trọng hơn — và thường bị bỏ qua — là availability của hệ thống bằng tích của availability các component, không phải tổng hay trung bình.
Nếu service A có availability 99.9% và service B có 99.9%, khi bạn chain chúng lại:
Availability tổng = 99.9% × 99.9% = 99.8%
Bạn vừa mất đi một “số chín” chỉ vì thêm một dependency. Đây là lý do tại sao microservices phức tạp thường khó đạt SLA cao hơn monolith nếu không được thiết kế cẩn thận.
Giải pháp là redundancy, với công thức: Availability = 1 - (1 - p)^n, trong đó p là availability của một node và n là số node dự phòng. Hai server 99% chạy song song cho bạn: 1 - (1 - 0.99)^2 = 99.99%.
Câu hỏi thực tế: Bạn có thực sự cần five nines không? Hệ thống thanh toán — có thể có. Blog công ty — chắc chắn không. Mỗi “số chín” thêm vào đồng nghĩa với chi phí infrastructure và độ phức tạp tăng theo cấp số nhân.
Throughput Benchmarks: Biết Giới Hạn Của Từng Component
Trước khi chọn technology stack, hãy biết các con số này:
Nginx:          ~50,000 - 100,000 req/s (single server)
PostgreSQL:     ~5,000 - 15,000 queries/s (simple queries)
MySQL:          ~10,000 - 30,000 queries/s
Redis:          ~100,000 - 1,000,000 ops/s
Kafka:          ~1,000,000 messages/s (per broker)
MongoDB:        ~20,000 - 80,000 ops/s
Memcached:      ~200,000 - 1,000,000 ops/s
Những con số này hướng dẫn trực tiếp việc chọn công nghệ. Nếu bạn cần 200.000 read ops/giây cho session data, PostgreSQL không thể đáp ứng — Redis là lựa chọn hiển nhiên. Nếu bạn cần ingest 500.000 events/giây, Kafka phù hợp hơn nhiều so với một REST API thông thường.
Lưu ý quan trọng: Đây là con số tham chiếu, không phải tuyệt đối. Hardware, cấu hình, độ phức tạp của query đều ảnh hưởng. Luôn thêm buffer 2-3x khi lập kế hoạch capacity để có đủ headroom cho traffic spike và growth.
Framework RQPS: Phương Pháp Estimation 5 Bước
Đây là framework bạn nên áp dụng mỗi khi cần ước tính quy mô hệ thống:
Bước 1 — Clarify Requirements
Trước khi tính bất cứ điều gì, hãy xác định: DAU là bao nhiêu? Tỷ lệ read/write là bao nhiêu? Dữ liệu cần giữ trong bao lâu? Sai ở bước này, mọi con số sau đều vô nghĩa.
Bước 2 — QPS Estimation
QPS = DAU × requests_per_user_per_day ÷ 86,400
Peak QPS = QPS × 2 (hoặc × 3 với hệ thống có traffic spike)
Bước 3 — Storage Estimation
Daily storage = DAU × writes_per_user × data_size_per_write
Total storage = Daily storage × retention_years × 365
Bước 4 — Bandwidth Estimation
Incoming = Write QPS × request_size
Outgoing = Read QPS × response_size
Bước 5 — Server & Cache Estimation
Servers needed = Peak QPS ÷ QPS_per_server
Cache size = Hot data volume × cache_hit_ratio
Ví Dụ Thực Tế: Thiết Kế Twitter-Like Feed Cho 10 Triệu DAU
Hãy áp dụng framework RQPS vào một bài toán cụ thể:
Requirements: 10 triệu DAU, mỗi user đọc 20 tweet và đăng 1 tweet/ngày, read/write ratio = 20:1, retention 5 năm.
QPS:
Write QPS = 10,000,000 × 1 ÷ 86,400 ≈ 116 writes/s
Read QPS  = 10,000,000 × 20 ÷ 86,400 ≈ 2,315 reads/s
Peak Read QPS ≈ 2,315 × 3 ≈ 6,945 reads/s
Storage:
Daily tweet storage = 10,000,000 × 300 bytes ≈ 3 GB/ngày
Total (5 năm) = 3 GB × 365 × 5 ≈ 5.5 TB
Bandwidth:
Incoming = 116 × 300 bytes ≈ 35 KB/s
Outgoing = 2,315 × 300 bytes ≈ 695 KB/s (text only)
Servers: Với PostgreSQL ~10,000 reads/s, bạn cần ít nhất 1 server cho read, nhưng với peak 6,945 reads/s và cần buffer, hãy plan cho 2-3 read replicas. Với 6,945 reads/s và cache hit ratio 80%, chỉ ~1,389 reads/s thực sự hit database — hoàn toàn quản lý được.
Kết luận kiến trúc từ các con số: Cần caching layer (Redis) để handle read traffic, CDN cho media content, và read replicas cho database. Không cần Kafka hay microservices phức tạp ở giai đoạn này. Toàn bộ analysis này mất chưa đến 10 phút.
Những Sai Lầm Phổ Biến Cần Tránh
- Quá chính xác: Estimation là về order of magnitude. “Khoảng 3 GB/ngày” tốt hơn “3.047 GB/ngày” — con số sau tạo ảo giác precision mà không thêm giá trị.
- Quên peak traffic multiplier: Average QPS không phải design QPS. Hệ thống Shopee trong ngày 11/11, hay Grab trong giờ cao điểm chiều tối, có thể gấp 5-10 lần traffic bình thường.
- Cộng availability thay vì nhân: Hai service 99.9% không cho bạn 99.9% — mà là 99.8%. Đây là sai lầm kiến trúc nghiêm trọng.
- Dùng con số lỗi thời: Hardware cải thiện liên tục. NVMe SSD hiện tại nhanh hơn đáng kể so với SATA SSD của 5 năm trước. Hãy sanity-check bảng tham chiếu của