DSPy + LiteLLM + ChatGPT: Xây Dựng Pipeline AI Thông Minh Hơn Năm 2026
Mở Đầu: Khi Prompt Engineering Trở Thành Gánh Nặng
Bạn đã bao giờ dành cả buổi chiều để tinh chỉnh một prompt, chỉ để nhận ra rằng khi đổi model hoặc thêm một bước xử lý mới, toàn bộ logic lại sụp đổ? Đó là thực tế mà hầu hết các kỹ sư AI đang đối mặt vào năm 2026. Prompt engineering thủ công vừa tốn thời gian, vừa dễ vỡ, vừa cực kỳ khó bảo trì khi hệ thống scale lên.
May mắn thay, một kiến trúc ba lớp đang nổi lên như một giải pháp thực tiễn và mạnh mẽ: DSPy để tối ưu hóa pipeline thông minh, LiteLLM (hoặc các CLI Proxy API tương tự) để kiểm soát chi phí và linh hoạt chuyển đổi model, và ChatGPT-compatible APIs làm chuẩn giao tiếp thống nhất. Kết hợp lại, ba công nghệ này tạo ra một kiến trúc mà bạn có thể viết một lần, chạy ở bất kỳ đâu — từ GPT-4o của OpenAI đến mô hình Llama chạy local — mà không cần thay đổi một dòng code nào.
Bài viết này sẽ đi sâu vào từng thành phần, cách kết nối chúng lại với nhau, và những best practices để xây dựng LLM pipeline chuẩn production trong năm 2026.
DSPy Là Gì Và Tại Sao Nó Thay Đổi Cuộc Chơi
DSPy (Declarative Self-improving Python) được phát triển bởi Omar Khattab và nhóm Stanford NLP, với một triết lý cốt lõi rất khác biệt: thay vì viết prompt, bạn định nghĩa hành vi.
Trong DSPy, bạn khai báo Signature — tức là input và output mà bạn mong muốn — và framework sẽ tự động compile, tối ưu hóa prompt phù hợp. Không còn việc ngồi căn chỉnh từng từ trong prompt template nữa.
Các Abstraction Chính Trong DSPy
- Signatures: Định nghĩa “hợp đồng” giữa input và output. Ví dụ:
question -> answerhaycontext, question -> reasoning, answer. - Modules: Các khối xây dựng pipeline như
dspy.ChainOfThought(suy luận từng bước) vàdspy.ReAct(agent sử dụng tool). Chúng hoạt động giống như các layer trong neural network — có thể kết hợp và tái sử dụng. - Teleprompters / Optimizers: Đây là phần ma thuật. Các optimizer như
BootstrapFewShotvàMIPRO v2tự động tìm kiếm các few-shot examples và cấu hình prompt tối ưu dựa trên metric bạn định nghĩa.
Sự thay đổi tư duy ở đây rất quan trọng: thay vì prompt engineering, bạn đang làm program-based LLM development. Pipeline của bạn là một chương trình có cấu trúc, có thể test, debug, và optimize một cách hệ thống — không phải một đống string template dễ vỡ.
CLI Proxy API Là Gì Và Tại Sao Bạn Cần Nó
CLI Proxy API là một lớp middleware đứng giữa code của bạn và các LLM provider. Nó expose một giao diện thống nhất — thường là OpenAI-compatible — để bạn có thể gọi bất kỳ model nào mà không cần thay đổi code ứng dụng.
Các Công Cụ Nổi Bật Trong Danh Mục Này
- LiteLLM: Proxy phổ biến nhất, hỗ trợ 100+ provider. Có thể khởi động bằng một lệnh CLI duy nhất và cung cấp đầy đủ tính năng production như caching, logging, fallback, và load balancing.
- Ollama: Giải pháp lý tưởng để chạy model local (Llama, Mistral, Qwen…) với OpenAI-compatible endpoint.
- vLLM: Inference server hiệu năng cao cho GPU, phù hợp với enterprise deployment.
- OpenRouter: Cloud-based router cho phép truy cập nhiều model từ nhiều provider qua một API key duy nhất.
- LocalAI: Tương tự Ollama nhưng hỗ trợ nhiều backend hơn, phù hợp với môi trường on-premise.
Lợi Ích Cốt Lõi
Lý do bạn cần một proxy layer không chỉ là tiện lợi — đó là chiến lược:
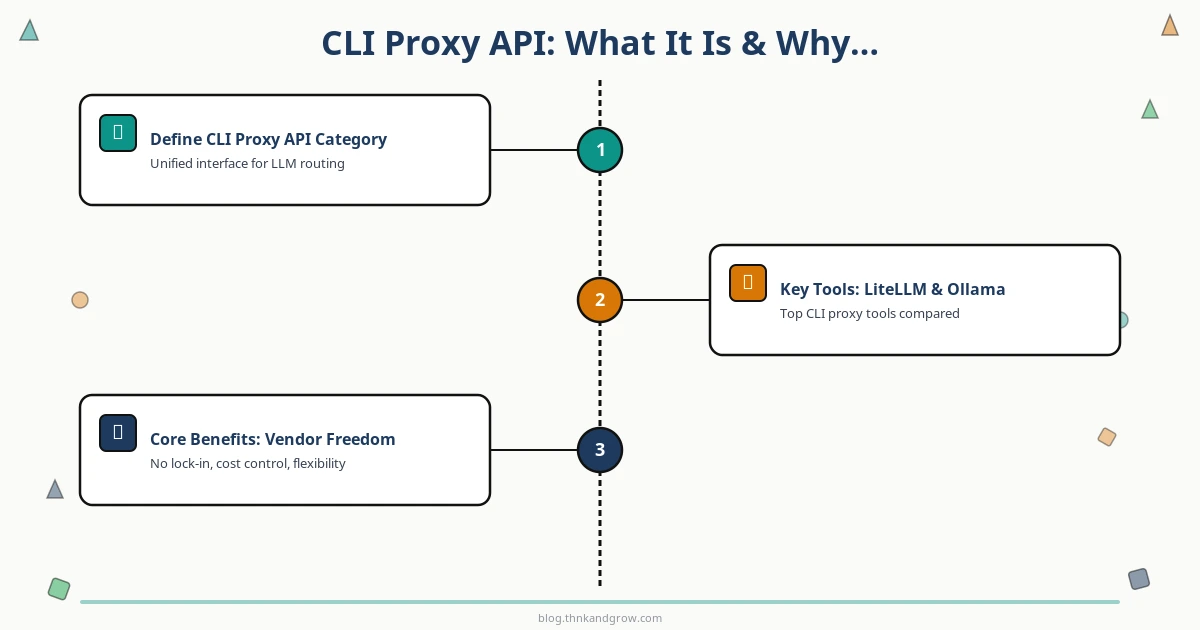
- Loại bỏ vendor lock-in: Hôm nay dùng GPT-4o, ngày mai muốn thử Claude hay Gemini? Chỉ cần đổi config proxy, không cần sửa code.
- Kiểm soát chi phí: Route các task đơn giản sang model rẻ hơn, task phức tạp mới dùng model đắt tiền.
- Private inference: Dữ liệu nhạy cảm? Chạy Ollama local, không một byte nào rời khỏi máy chủ của bạn.
- Request routing thông minh: LiteLLM cho phép thiết lập fallback tự động — nếu GPT-4o timeout, tự động chuyển sang model backup.
ChatGPT Fits Into Architecture Như Thế Nào
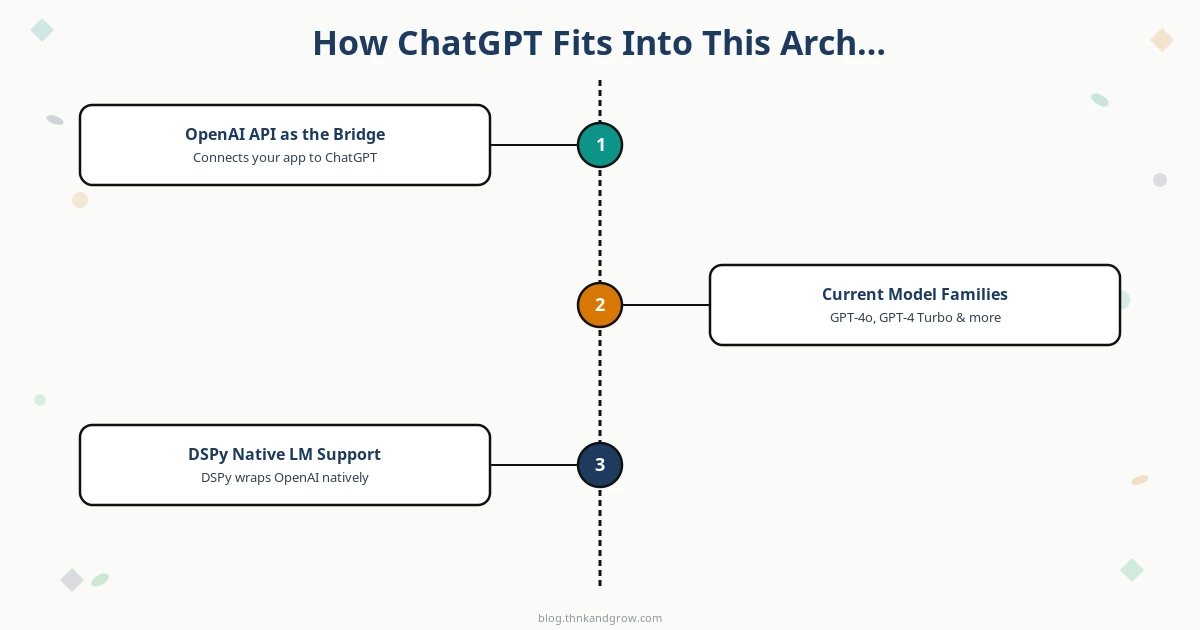
OpenAI không chỉ là một LLM provider — họ đã định nghĩa chuẩn giao tiếp mà cả ngành đang dùng. Endpoint /v1/chat/completions với format JSON của OpenAI đã trở thành lingua franca của thế giới LLM, và đó là lý do tại sao tất cả các proxy tool đều emulate nó.
Dòng Model Hiện Tại (2026)
- GPT-4o: Model đa năng mạnh nhất, hỗ trợ multimodal, phù hợp với reasoning phức tạp.
- GPT-4o-mini: Rẻ hơn đáng kể, chất lượng tốt cho các task classification, extraction, summarization.
- o1/o3 reasoning models: Dành cho các bài toán cần extended thinking — toán học, lập luận nhiều bước, code phức tạp. Chi phí cao hơn nhưng độ chính xác vượt trội.
DSPy hỗ trợ tất cả các endpoint OpenAI-compatible thông qua wrapper dspy.LM. Pattern chuẩn hiện nay là:
lm = dspy.LM("openai/gpt-4o", base_url="http://localhost:4000", api_key="your-key")
Pattern này hoạt động với bất kỳ proxy nào — LiteLLM, Ollama, vLLM — miễn là proxy đó expose OpenAI-compatible endpoint.
Thiết Lập Stack: DSPy + LiteLLM Proxy + ChatGPT
Đây là phần thực hành. Hãy cùng xây dựng một pipeline hoàn chỉnh từ đầu.
Bước 1: Cài Đặt Dependencies
pip install dspy-ai litellm
Bước 2: Khởi Động LiteLLM Proxy Server
Tạo file litellm_config.yaml:
model_list:
  - model_name: gpt-4o
    litellm_params:
      model: openai/gpt-4o
      api_key: "sk-your-openai-key"
  - model_name: gpt-4o-mini
    litellm_params:
      model: openai/gpt-4o-mini
      api_key: "sk-your-openai-key"
Sau đó khởi động proxy bằng CLI:
litellm --config litellm_config.yaml --port 4000
Bước 3: Kết Nối DSPy Với Proxy
import dspy

lm = dspy.LM(
    "openai/gpt-4o",
    base_url="http://localhost:4000",
    api_key="anything"  # LiteLLM xử lý auth nội bộ
)
dspy.configure(lm=lm)
Bước 4: Xây Dựng Pipeline DSPy Đơn Giản
class QASignature(dspy.Signature):
    """Trả lời câu hỏi dựa trên ngữ cảnh được cung cấp."""
    context: str = dspy.InputField()
    question: str = dspy.InputField()
    answer: str = dspy.OutputField()

class SmartQA(dspy.Module):
    def __init__(self):
        self.cot = dspy.ChainOfThought(QASignature)

    def forward(self, context, question):
        return self.cot(context=context, question=question)

qa = SmartQA()
result = qa(
    context="DSPy là framework tối ưu hóa LLM pipeline tự động.",
    question="DSPy làm gì?"
)
print(result.answer)
Chỉ vậy thôi. Pipeline của bạn đang chạy qua LiteLLM proxy, và bạn có thể switch sang bất kỳ model nào chỉ bằng cách thay đổi config.
Các Use Case Thực Tế Của Stack Này
1. Pipeline Tối Ưu Chi Phí
Đây là use case phổ biến nhất trong môi trường production. Với LiteLLM, bạn có thể thiết lập routing rules: các task phức tạp như phân tích pháp lý hay reasoning nhiều bước được route sang GPT-4o, trong khi classification đơn giản hay trích xuất entity được gửi đến GPT-4o-mini. Kết quả thực tế: tiết kiệm 60–80% chi phí API mà không giảm chất lượng đáng kể.
2. Private/Enterprise Inference
Nếu bạn làm việc với dữ liệu y tế, tài chính, hay pháp lý — dữ liệu không thể rời khỏi infrastructure của bạn — chỉ cần thay đổi config LiteLLM để point sang Ollama chạy local:
lm = dspy.LM(
    "openai/llama3.1",
    base_url="http://localhost:11434/v1",
    api_key="ollama"
)
dspy.configure(lm=lm)
Không cần thay đổi một dòng DSPy code nào. Đây chính là sức mạnh của kiến trúc này.
3. Multi-Model Experimentation
Dùng DSPy’s optimizer để benchmark cùng một pipeline logic trên nhiều model khác nhau qua proxy. Bạn có thể so sánh GPT-4o vs Claude vs Llama trên cùng một metric đánh giá, từ đó chọn model tốt nhất cho từng task cụ thể.
Best Practices Và Những Lỗi Cần Tránh
Nên Làm
- Luôn dùng
dspy.configure(lm=...)làm phương thức setup model chính. Cách này tạo ra code sạch, dễ bảo trì, và dễ swap model khi cần. - Tận dụng LiteLLM caching với Redis để giảm chi phí cho các request lặp lại — đặc biệt hữu ích trong quá trình development và testing.
- Bật logging PostgreSQL trong LiteLLM để có visibility đầy đủ về chi phí, latency, và error rate của từng model.
- Test proxy connectivity trước khi chạy DSPy optimization loops. Một optimization run có thể tốn hàng trăm API calls — đừng để lỗi kết nối làm hỏng cả quá trình.
Không Nên Làm
- Đừng over-optimize quá sớm. Chỉ chạy DSPy teleprompters (như MIPRO v2) sau khi pipeline logic của bạn đã ổn định. Optimize một pipeline chưa hoàn thiện là lãng phí tài nguyên.
- Đừng hardcode API key trong code DSPy. Để LiteLLM proxy xử lý authentication — code của bạn chỉ cần biết địa chỉ proxy.
- Đừng bỏ qua evaluation. DSPy cung cấp
dspy.Evaluate— hãy định nghĩa metric rõ ràng trước khi chạy optimizer, nếu không kết quả optimize sẽ vô nghĩa.
Toàn Cảnh Hệ Sinh Thái: Con Người, Công Cụ Và Tương Lai
Để hiểu đầy đủ về stack này, cần biết những người đứng sau nó:
- Omar Khattab (Stanford → Databricks): Cha đẻ của DSPy, hiện đang phát triển framework dưới sự hỗ trợ của Databricks với nguồn lực lớn hơn nhiều.
- Stanford NLP Group: Nơi DSPy được sinh ra, tiếp tục đóng góp research về automatic prompt optimization.
- Ishaan Jaffer: Co-creator của LiteLLM, đang xây dựng enterprise tier với các tính năng như SSO, audit logging, và role-based access control.
DSPy 2.5+ và Những Gì Đang Đến
DSPy 2.5+ đã mang lại nhiều cải tiến đáng kể: multi-LM support trong một pipeline duy nhất, async execution, MIPRO v2 với hiệu quả tối ưu hóa tốt hơn, và bridges với LangChain/LlamaIndex để tích hợp vào ecosystem rộng hơn.
Nhìn về phía trước, ba xu hướng đáng chú ý:
- Structured Outputs: Native JSON schema enforcement từ OpenAI kết hợp với DSPy Signatures tạo ra pipeline cực kỳ reliable.
- Reasoning Models (o3): DSPy’s optimizer sẽ học cách tận dụng extended thinking của o3 cho các task phức tạp nhất.
- Enterprise Adoption: Ngày càng nhiều tổ chức lớn đang adopt stack này như một standard architecture cho LLM applications.
Kết Luận: Bắt Đầu Nhỏ, Scale Lớn
Kiến trúc ba lớp — DSPy cho pipeline logic thông minh, CLI Proxy API cho sự linh hoạt và kiểm soát chi phí, ChatGPT-compatible APIs làm chuẩn giao tiếp thống nhất — không phải là một xu hướng nhất thời. Đây là một trong những kiến trúc thực tiễn nhất để xây dựng LLM systems chu