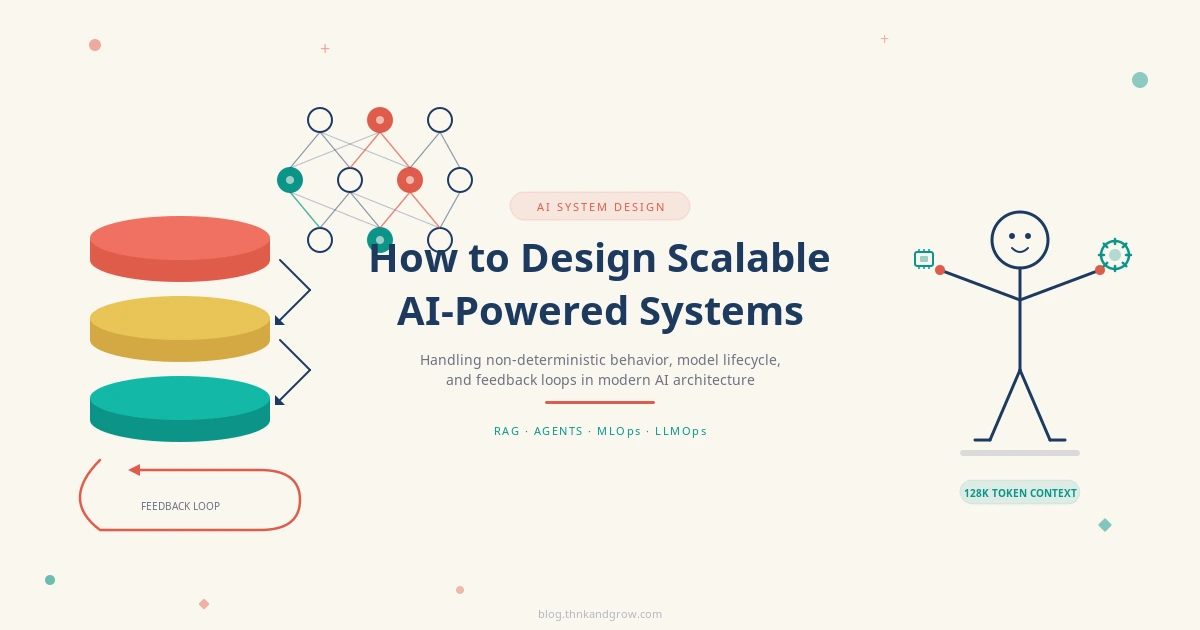
Cách Xây Dựng Hệ Thống AI Có Khả Năng Mở Rộng Năm 2026
Năm 2022, câu hỏi mà mọi team kỹ thuật đặt ra là: “Làm sao để model AI này hoạt động được?” Năm 2026, câu hỏi đó đã hoàn toàn thay đổi: “Làm sao để hệ thống AI này hoạt động ổn định, có thể mở rộng, và không đốt hết ngân sách compute trong vòng ba tháng?”
Đây là sự chuyển dịch căn bản mà bất kỳ engineer nào đang làm việc với AI production cần phải nhận ra. Getting a model to work — fine-tuning, prompting, evaluation — đó không còn là phần khó nhất nữa. Phần khó là xây dựng infrastructure xung quanh nó: data pipeline đáng tin cậy, serving layer có khả năng chịu tải, observability đủ sâu để phát hiện khi model bắt đầu “nói bậy” mà không có error log nào cảnh báo bạn.
Bài viết này dành cho các software engineer, ML engineer, và technical architect đang ở giai đoạn xây dựng hoặc scale AI-powered applications trong production. Chúng ta sẽ đi qua toàn bộ stack — từ data ingestion đến inference optimization, từ RAG architecture đến LLMOps — với góc nhìn thực tế, không phải lý thuyết hàn lâm.
Tại Sao AI System Design Khác Hoàn Toàn với Traditional Software Architecture
Traditional software có một đặc điểm quý giá mà chúng ta thường xuyên bỏ qua: nó fail loud. Khi có bug, bạn có stack trace. Khi service down, bạn có alert. Khi database query sai, bạn có error. AI systems không làm vậy.
AI systems fail silently. Model drift xảy ra từ từ trong nhiều tuần. Output quality giảm dần mà không có exception nào được throw. Một recommendation system có thể bắt đầu bias về một nhóm người dùng nhất định mà không có alarm nào kêu lên — cho đến khi báo chí đưa tin. Đây là lý do tại sao AI system design đòi hỏi một tư duy hoàn toàn khác.
Ngoài non-deterministic behavior, có một số concern hoàn toàn mới mà traditional software architecture không cần đối mặt:
- Model lifecycle management: Model không phải code — nó có training data, versioning riêng, và cần retraining khi distribution của data thay đổi.
- Feedback loops: Output của model ảnh hưởng đến input của model trong tương lai. Đây là một trong những nguồn gốc phổ biến nhất của production AI failures.
- Compute cost management: OpenAI từng tốn khoảng 700,000 USD/ngày cho ChatGPT compute. Với các tổ chức nhỏ hơn, inference cost không được tối ưu có thể dễ dàng vượt quá toàn bộ infrastructure budget.
- Regulatory compliance: EU AI Act đang có hiệu lực, yêu cầu explainability và auditability cho các AI systems ở nhiều lĩnh vực. Đây không còn là nice-to-have — đây là architectural requirement.
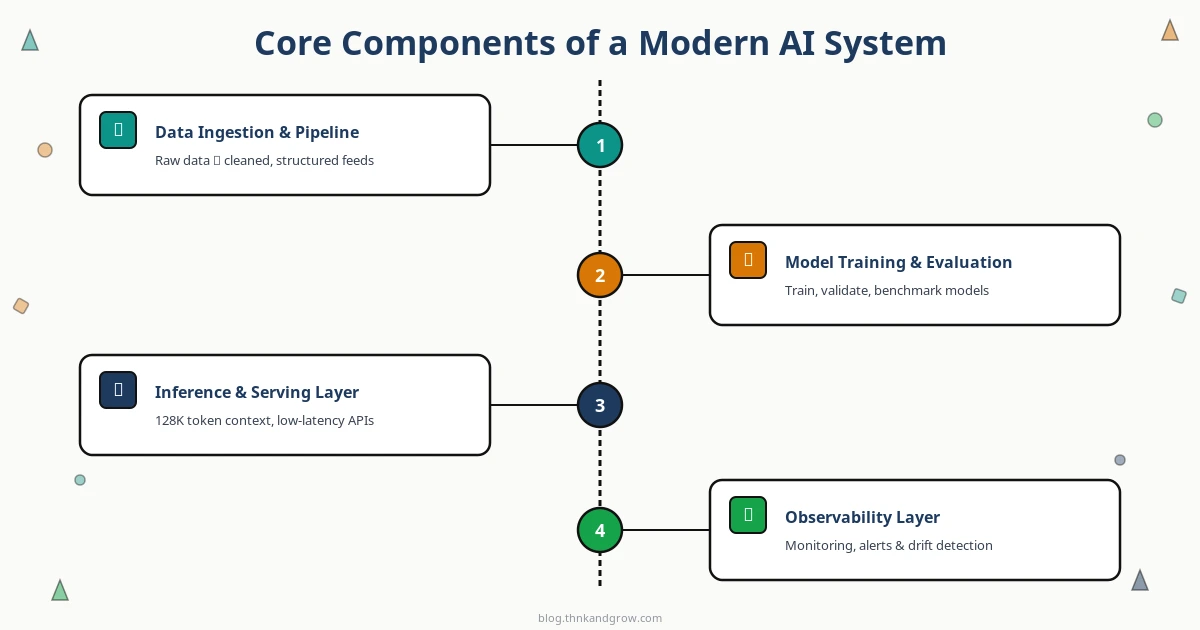
Các Thành Phần Cốt Lõi của Một AI System Hiện Đại
Một production AI system không phải là một model đứng một mình. Nó là một tập hợp các layer phối hợp với nhau, và mỗi layer đều có thể trở thành bottleneck nếu thiết kế kém.
Data Ingestion và Pipeline Layer
Mọi thứ bắt đầu từ data. Pipeline layer chịu trách nhiệm ingestion, cleaning, transformation, và versioning data ở quy mô lớn. Điểm quan trọng ở đây là data versioning — bạn cần biết chính xác model version X được train trên data nào, để có thể reproduce kết quả và debug khi cần. DVC (Data Version Control) và Delta Lake là hai công cụ phổ biến cho việc này.
Model Training và Evaluation Infrastructure
Experiment tracking không phải là luxury — đây là nền tảng của reproducibility. Nếu bạn không biết hyperparameter nào đã được dùng, data version nào đã được sử dụng, và environment nào đã chạy experiment đó, bạn không có một ML system, bạn có một black box. MLflow và Weights & Biases giải quyết vấn đề này, kết hợp với model registry để quản lý vòng đời của model.
Inference và Serving Layer
Đây là nơi mà các trade-off trở nên rõ ràng nhất. Latency thấp hay throughput cao? Self-hosted hay managed API? Real-time hay batch inference? Không có câu trả lời đúng cho tất cả — chỉ có câu trả lời phù hợp với use case cụ thể của bạn.
Observability Layer
Monitoring cho AI systems phải đi xa hơn traditional APM. Bạn cần track không chỉ latency và error rate, mà còn model drift (khi distribution của input data thay đổi so với training data), output quality degradation, và bias metrics. Langfuse và Arize AI là hai tool đáng chú ý trong không gian này.
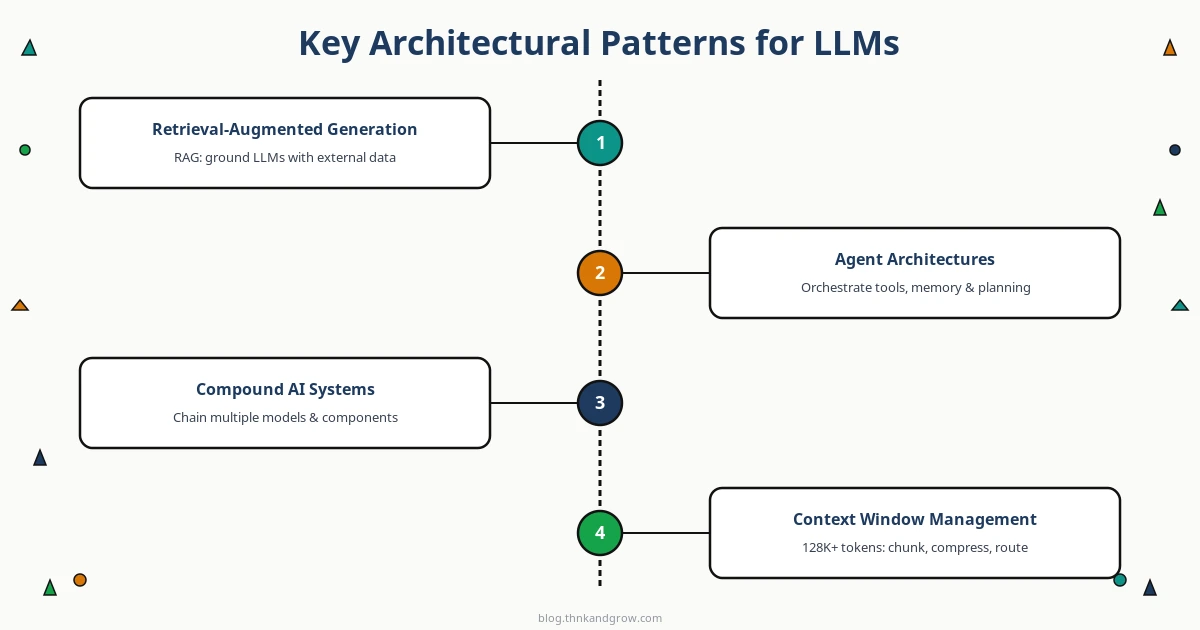
Các Architectural Pattern Chính cho LLM-Powered Applications
Sau hai năm production LLM deployments, ngành đã hội tụ về một số pattern đã được chứng minh. Đây không phải là trend — đây là engineering best practices.
Retrieval-Augmented Generation (RAG)
RAG là pattern phổ biến nhất cho enterprise LLM applications, và có lý do chính đáng. Thay vì cố gắng nhét toàn bộ knowledge vào weights của model (tốn kém, chậm, và không thể cập nhật real-time), RAG tách biệt knowledge store ra ngoài và retrieve relevant context tại inference time.
Architecture cơ bản: user query được embed thành vector, tìm kiếm trong vector database để lấy relevant documents, sau đó documents này được đưa vào context window của LLM cùng với query gốc. Kết quả là responses được “grounded” trong actual data của bạn, không phải hallucination.
Lựa chọn vector database phụ thuộc vào scale và existing stack: Pinecone cho managed simplicity, Qdrant cho performance cao với self-hosted, pgvector nếu bạn đã có Postgres và muốn giảm operational complexity.
Agent Architectures
Agent systems cho phép LLM không chỉ generate text mà còn thực hiện hành động: gọi API, chạy code, tìm kiếm web, query database. Đây là paradigm shift quan trọng, nhưng cũng đi kèm với complexity đáng kể về state management, error handling, và safety guardrails.
Một agent architecture điển hình sử dụng một “reasoning loop” — thường là ReAct (Reason + Act) pattern — trong đó LLM lần lượt suy nghĩ, chọn tool, thực thi, quan sát kết quả, và lặp lại. CrewAI và AutoGen của Microsoft là hai framework đáng để xem xét cho multi-agent scenarios.
Compound AI Systems
Thuật ngữ này được BAIR (Berkeley AI Research) và Databricks popularize năm 2024. Compound AI systems chain nhiều models, retrievers, và tools lại với nhau trong một unified workflow. Ví dụ: một document processing pipeline có thể dùng một vision model để extract text từ PDF, một classifier để categorize document, và một LLM để generate summary — tất cả orchestrated trong một single pipeline.
Context Window Management
Với context windows lên đến 1 triệu tokens, người ta dễ có xu hướng “nhét hết vào đó cho chắc.” Đây là sai lầm tốn kém. Mỗi token trong context window đều có cost — cả về latency lẫn tiền. Các chiến lược như sliding window, hierarchical summarization, và selective context injection là những kỹ thuật cần nắm vững.
Lựa Chọn Tools và Infrastructure Stack Phù Hợp
Không có stack nào là tốt nhất cho tất cả. Nhưng có một số nguyên tắc để lựa chọn.
Về cloud platforms: AWS Bedrock và Google Vertex AI phù hợp cho teams muốn managed experience với nhiều model choices. Azure OpenAI Service là lựa chọn tự nhiên nếu tổ chức đã deep trong Microsoft ecosystem. Databricks nổi bật nếu bạn có heavy data engineering workloads cần kết hợp với ML.
Về model serving engines: vLLM hiện là de facto standard cho open-source LLM serving, nhờ PagedAttention giúp quản lý GPU memory hiệu quả hơn đáng kể. TensorRT-LLM của NVIDIA cho throughput tối đa nếu bạn đang chạy trên NVIDIA GPUs. Ray Serve phù hợp cho complex inference graphs với nhiều models.
Về orchestration frameworks: LangChain vẫn là lựa chọn phổ biến nhất nhờ ecosystem rộng, nhưng DSPy của Stanford đang được chú ý nhiều cho các teams muốn optimize prompts một cách có hệ thống thay vì hand-craft. LlamaIndex tập trung hơn vào RAG pipelines và thường là lựa chọn tốt hơn cho document-heavy applications.
MLOps và LLMOps: Giữ Cho AI Systems Khỏe Mạnh trong Production
Đây là phần mà nhiều teams bỏ qua vội vàng để ship sản phẩm, rồi hối hận sau đó. MLOps không phải là overhead — đây là insurance policy cho production AI systems của bạn.
Experiment tracking và model versioning phải được thiết lập từ ngày đầu, không phải sau khi đã có vấn đề. MLflow là lựa chọn open-source mạnh mẽ; Weights & Biases cung cấp UX tốt hơn và collaboration features nếu budget cho phép.
Feature stores giải quyết một vấn đề cụ thể nhưng quan trọng: đảm bảo rằng features được tính toán theo cùng một cách trong cả training lẫn serving. Training-serving skew — khi features ở training time khác với features ở inference time — là một trong những nguyên nhân phổ biến nhất của mysterious model degradation.
Continuous monitoring cần được thiết kế vào system từ đầu. Với LLM applications, điều này bao gồm cả việc track output quality thông qua LLM-as-judge patterns — dùng một LLM khác để evaluate output của LLM chính theo các tiêu chí được định nghĩa trước.
Retraining pipelines đóng vòng lặp quan trọng nhất: đưa production signals (user feedback, correction data, performance metrics) trở lại quá trình training để model liên tục cải thiện. Đây là điểm khác biệt giữa một AI system stagnant và một AI system thực sự learning.
Thiết Kế Cho Cost, Latency, và Scale
Đây là phần kỹ thuật nhất và cũng là nơi mà quyết định thiết kế có tác động tài chính trực tiếp nhất.
Inference cost optimization có nhiều lever khác nhau. Quantization (giảm precision của model weights từ FP16 xuống INT8 hoặc INT4) có thể giảm memory footprint và tăng throughput đáng kể với minimal quality loss. Speculative decoding — dùng một draft model nhỏ hơn để generate tokens, sau đó verify bằng model lớn — giảm latency mà không ảnh hưởng đến output quality. Semantic caching (cache responses cho các queries tương tự nhau về mặt ngữ nghĩa) có thể giảm API costs lên đến 40-60% cho nhiều use cases.
AI Gateways như Kong AI Gateway, Portkey, và LiteLLM đang trở thành một layer quan trọng trong production stacks. Chúng cung cấp rate limiting, intelligent routing giữa các LLM providers, cost tracking, và fallback logic — tất cả trong một single control plane.
Edge AI là một lựa chọn đáng xem xét nghiêm túc cho các use cases nhạy cảm về latency hoặc privacy. Apple Core ML và Gemini Nano cho phép inference trực tiếp trên device, loại bỏ hoàn toàn network round-trip và giữ data trên thiết bị của người dùng.
Synchronous vs. asynchronous inference là một trong những quyết định architectural quan trọng nhất. Không phải mọi AI request đều cần real-time response. Batch processing cho document analysis, async queues cho background AI tasks — những pattern này có thể giảm infrastructure cost đáng kể bằng cách cho phép better GPU utilization.
Các Xu Hướng Đang Định Hình AI System Design Năm 2026
Mixture of Experts (MoE) đang thay đổi cách chúng ta nghĩ về inference infrastructure. Thay vì activate toàn bộ model cho mỗi token, MoE chỉ activate một subset của “expert” networks. Điều này có nghĩa là model có thể lớn hơn nhiều về tổng số parameters nhưng inference cost không tăng tương ứng — nhưng đòi hỏi infrastructure ph