Hành Trình Debug Proxy Trong Hệ Thống AI Đa Tác Nhân
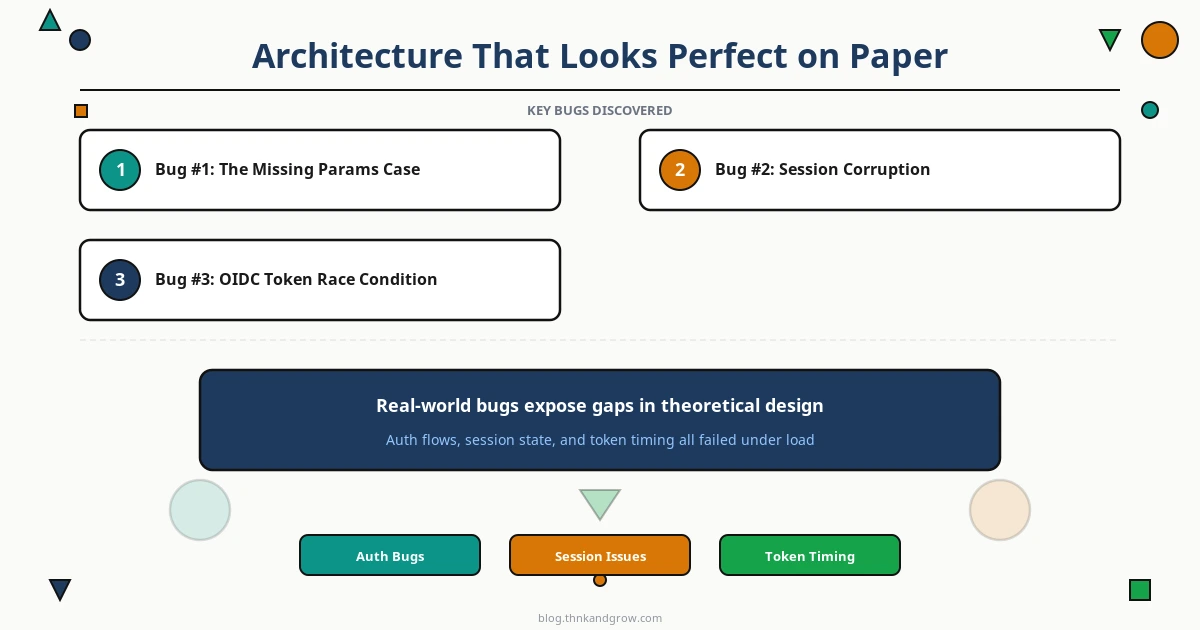
Mọi thứ trông có vẻ hoàn hảo trên giấy tờ. Một nhóm agent AI tự trị hoạt động trên Discord, được hỗ trợ bởi Claude Sonnet 4.6 thông qua hạ tầng bảo mật của GitLab — khả năng tìm kiếm tài liệu, thực thi code, và phối hợp với nhau trong thời gian thực. Chúng tôi có kiến trúc rõ ràng, có đội ngũ kỹ thuật giàu kinh nghiệm, và có một tuần sprint để triển khai. Những gì thực sự xảy ra sau đó là một hành trình dài một tuần đi sâu vào cơ chế nội tại của Vercel AI SDK, quá trình trao đổi OIDC token, và những cách thức âm thầm, tinh vi mà các lớp dịch thuật message có thể làm hỏng trạng thái của một LLM.
Đây không phải là câu chuyện về một bug đơn lẻ. Đây là câu chuyện về ba lớp lỗi chồng chất lên nhau, mỗi lớp che khuất lớp tiếp theo, tất cả đều bắt nguồn từ một sự thật cơ bản: khi bạn xây dựng bridge software — phần mềm cầu nối giữa hai hệ sinh thái — bạn không chỉ viết code chuyển đổi format. Bạn đang cố gắng ánh xạ hai thế giới quan hoàn toàn khác nhau về cách một cuộc hội thoại nên được cấu trúc. Và khi ánh xạ đó thất bại âm thầm, hệ thống tiếp tục chạy với dữ liệu đã bị hỏng — không có exception, không có log cảnh báo, chỉ có những kết quả sai lệch ngày càng khó giải thích hơn.
Bài viết này dành cho những senior engineer và AI/ML engineer đang xây dựng hệ thống agent AI trong production, đặc biệt là những người đang tích hợp các backend không phải OpenAI với các framework agent tương thích OpenAI. Năm 2026, đây không còn là edge case — đây là thực tế của bất kỳ team nào đang triển khai AI trong môi trường enterprise.
Kiến Trúc Trông Hoàn Hảo Trên Giấy
Để hiểu tại sao mọi thứ vỡ vụn, trước tiên cần hiểu tại sao kiến trúc này lại cần thiết ngay từ đầu.
OpenClaw được thiết kế để làm việc với các API tương thích OpenAI. GitLab AI Gateway, ngược lại, expose các model Anthropic thông qua một interface proprietary yêu cầu GitLab-specific headers và OIDC token tạm thời. Đây là mô hình phổ biến trong enterprise: các tổ chức muốn sử dụng các frontier model như Claude Sonnet 4.6 nhưng cần route chúng qua hạ tầng nội bộ để đảm bảo compliance, kiểm soát chi phí, và audit logging. Kết quả là một lớp proxy bắt buộc.
Chuỗi request đầy đủ trông như thế này:
OpenClaw (Discord Agent)
    → Custom Node.js Proxy
    → gitlab-ai-provider
    → GitLab AI Gateway
    → Anthropic (Claude Sonnet 4.6)
Proxy Node.js tùy chỉnh của chúng tôi sẽ xử lý việc dịch thuật từ OpenAI sang AI SDK, provider sẽ xử lý xác thực GitLab, và Gateway sẽ cung cấp model. Nhưng ẩn sâu trong thiết kế này là một sự không tương thích cơ bản mà chúng tôi chưa nhận ra: OpenAI sử dụng trường parameters để định nghĩa tool schema, trong khi Anthropic sử dụng input_schema. Một sự khác biệt nhỏ về tên trường — nhưng hậu quả của nó sẽ lan rộng theo những cách chúng tôi không ngờ tới.
Để so sánh, đây là format tool definition của hai hệ sinh thái:
// OpenAI format
{
  "name": "search_docs",
  "description": "Tìm kiếm tài liệu",
  "parameters": {
    "type": "object",
    "properties": {
      "query": { "type": "string" }
    }
  }
}

// Anthropic format
{
  "name": "search_docs",
  "description": "Tìm kiếm tài liệu",
  "input_schema": {
    "type": "object",
    "properties": {
      "query": { "type": "string" }
    }
  }
}
Sự khác biệt trông nhỏ nhặt đến mức buồn cười. Nhưng trong một hệ thống proxy nhiều lớp, mỗi tên trường là một điểm tải trọng — load-bearing — và khi nó sai, toàn bộ cấu trúc có thể sụp đổ mà không phát ra một tiếng động nào.
Bug #1: Vụ Án Về Những Tham Số Rỗng
Dấu hiệu rắc rối đầu tiên xuất hiện khi các agent cố gắng sử dụng tool. Chúng tôi thấy agent xác định đúng tool cần dùng, nhưng các tham số luôn trống rỗng:
{
  "role": "assistant",
  "tool_calls": [
    {
      "id": "call_abc123",
      "type": "function",
      "function": {
        "name": "search_docs",
        "arguments": "{}"
      }
    }
  ]
}
Agent biết nó muốn tìm kiếm tài liệu. Nhưng không biết tìm kiếm gì. Mỗi lần gọi tool đều là một cuộc gọi mù.
Sau nhiều giờ đào sâu vào logs, chúng tôi tìm ra nguyên nhân gốc rễ. gitlab-ai-provider v5.0.0 có một method convertTools() đang tìm kiếm tool.inputSchema.properties ở top level. Tuy nhiên, Vercel AI SDK’s jsonSchema() wrapper không đặt properties ở top level — nó lưu trữ schema thực sự dưới một property .jsonSchema.
Kết quả: .properties là undefined, provider mặc định về một object rỗng, và không có exception nào được throw. Đây là silent failure cổ điển — code tiếp tục chạy nhưng với dữ liệu đã bị hỏng. Không có stack trace để theo dõi, không có error message để Google. Chỉ có những tham số rỗng bí ẩn.
Vì không thể chờ đợi upstream fix, chúng tôi phải patch trực tiếp vào distribution files:
// Trước khi patch (trong dist/index.js và dist/index.mjs)
const props = raw.properties;

// Sau khi patch
const schema = raw?.jsonSchema ?? raw;
const props = schema.properties;
Ngoài ra, proxy của chúng tôi đang gửi schema dưới trường parameters (kiểu OpenAI), nhưng AI SDK lại expect inputSchema. Chúng tôi phải điều chỉnh translator để align với những gì SDK thực sự consume. Đây là lần đầu tiên chúng tôi nhận ra rằng lớp translation sẽ là một cơn ác mộng bảo trì.
Bài học #1: Patching distribution files là chiến lược hợp lệ trong ngắn hạn khi upstream fix chưa có, nhưng nó là dấu hiệu cảnh báo rằng bạn cần một giải pháp dài hạn bền vững hơn. Hãy document rõ ràng mọi patch bạn áp dụng và theo dõi upstream changelog để biết khi nào có thể loại bỏ chúng.
Bài học rộng hơn ở đây là về version drift: các community provider và rapidly evolving SDK sẽ luôn có khoảng cách. Khi Vercel AI SDK thay đổi cách nó wrap schemas trong một minor version, không phải tất cả các provider đều cập nhật kịp thời. Trong hệ thống agent production, đây không phải là sự bất tiện — đây là một lỗ hổng tiềm ẩn nghiêm trọng.
Bug #2: Session Corruption và Con Agent Đã Chết
Sau khi fix được Bug #1, chúng tôi nghĩ mình đã qua giai đoạn khó khăn nhất. Chúng tôi đã nhầm.
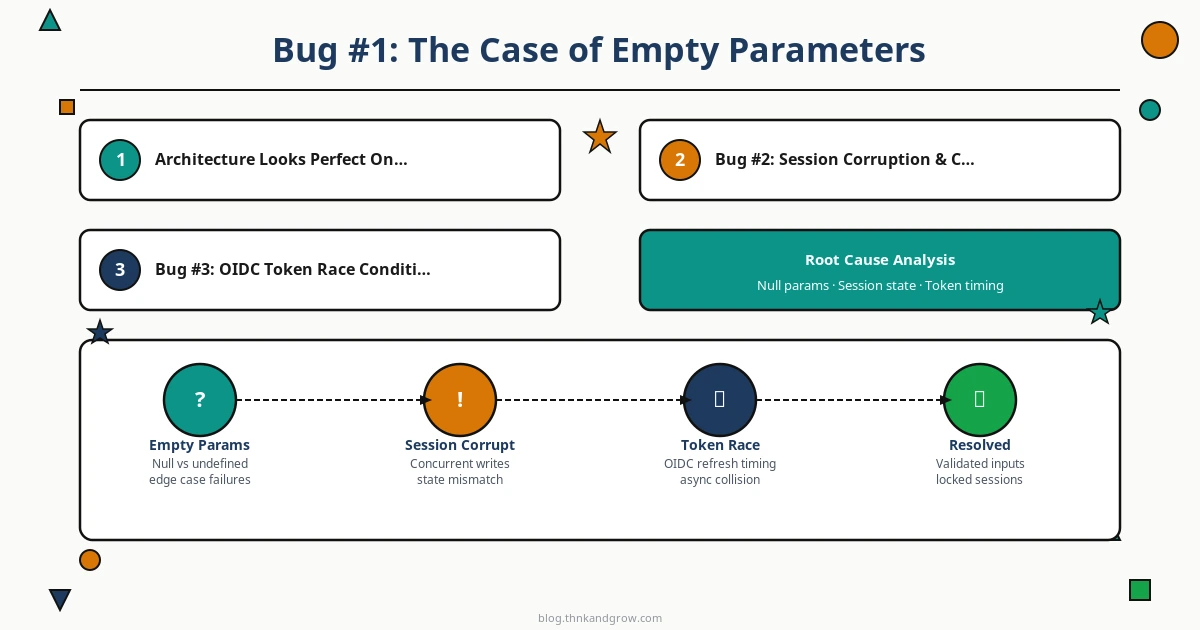
Ngay sau khi một agent thực thi thành công một tool và nhận được kết quả, mọi request tiếp theo trong cùng session đó sẽ trả về một response rỗng ngay lập tức. Các triệu chứng rất đặc trưng và nhất quán một cách đáng sợ:
- Response time: 30–90ms — quá nhanh để là LLM inference thực sự (thông thường mất 1–5 giây)
content: []— mảng content hoàn toàn rỗngtotalTokens: 0— không có token nào được xử lý- Agent “chết” cho đến khi chúng tôi xóa thủ công file JSON session
Đây là gì? Model không throw error. Không có HTTP 4xx hay 5xx. Chỉ là một response hợp lệ về mặt kỹ thuật nhưng hoàn toàn rỗng về nội dung. Con agent đã trở thành một cái vỏ rỗng.
Nguyên nhân gốc rễ là session state corruption. Khi tool result được trả về, message được format không đúng cách trước khi được thêm vào conversation history. LLM nhận được một conversation history chứa malformed tool result message — và thay vì throw error, nó đơn giản là trả về response rỗng. Đây là hành vi “fail silent” ở cấp độ model, không phải cấp độ code.
Vấn đề trở nên tồi tệ hơn bởi vì chúng tôi đang dùng file-based JSON session storage. Mỗi session được lưu vào một file JSON trên disk. Khi conversation history bị corrupt, sự corruption đó được persist qua mọi request tiếp theo. Agent không chỉ chết — nó chết một cách vĩnh viễn trong session đó.
Đây là cấu trúc của một malformed tool result message:
// Message BỊ CORRUPT trong conversation history
{
  "role": "tool",
  "tool_call_id": "call_abc123",
  "content": undefined  // ← Đây là vấn đề
}

// Message ĐÚNG format
{
  "role": "tool",
  "tool_call_id": "call_abc123",
  "content": "{ \"results\": [\"doc1.md\", \"doc2.md\"] }"
}
Fix ngắn hạn là xác định và sanitize malformed message trong conversation history, cộng với một workaround là xóa thủ công session file. Fix dài hạn là implement session validation — một layer kiểm tra tính toàn vẹn của conversation history trước mỗi request, tự động phát hiện và recover từ các malformed message.
Bài học #2: “Dead agent” problem là một thách thức chưa được giải quyết rộng rãi trong hệ thống agentic AI. Khi conversation history trở nên invalid, hầu hết LLM sẽ trả về empty response thay vì explicit error. File-based session storage làm cho failure mode này trở nên persistent và cực kỳ khó detect. Hãy implement session health checks như một first-class concern, không phải afterthought.
Bug #3: OIDC Token Race Condition và Những Lần Gọi Bị Mất
Khi chúng tôi nghĩ mình đã ổn định được hệ thống, bug thứ ba xuất hiện — và đây là bug khó chịu nhất vì nó không tái hiện một cách nhất quán.
Trong các session có nhiều agent hoạt động đồng thời, chúng tôi bắt đầu thấy các tool call thỉnh thoảng thất bại với lỗi authentication, nhưng chỉ trong các điều kiện tải cao. Đôi khi request sẽ thành công, đôi khi không — và không có pattern rõ ràng nào trong logs.
Sau khi điều tra, chúng tôi phát hiện
ra nguyên nhân: OIDC token được cache và tái sử dụng giữa các concurrent request, nhưng token có thể expire trong khoảng thời gian giữa lúc được cache và lúc được sử dụng. Khi nhiều agent cùng khởi tạo request gần như đồng thời, chúng có thể cùng nhau fetch một token mới — tạo ra một race condition nơi một số request nhận được token cũ đã expire trong khi token mới đang được fetch.
Đây là timeline của race condition:
T+0ms:   Agent A kiểm tra cache → token còn 200ms nữa expire
T+10ms:  Agent B kiểm tra cache → cùng token, vẫn "hợp lệ"
T+100ms: Agent A gửi request với token → SUCCESS
T+200ms: Token expire
T+210ms: Agent B gửi request với token đã expire → AUTH FAILURE
T+215ms: Agent B fetch token mới → SUCCESS
T+220ms: Agent C kiểm tra cache → nhận token mới từ Agent B
T+225ms: Agent D kiểm tra cache → nhưng Agent B chưa xong write...
Vấn đề cốt lõi là không có mutex hay lock mechanism nào quanh token refresh logic. Trong môi trường single-threaded của Node.js, điều này thường không phải vấn đề — nhưng với async/await và multiple concurrent Promises, race condition vẫn hoàn toàn có thể xảy ra.
Fix của chúng tôi là implement một token refresh lock pattern:
class OIDCTokenManager {
  private tokenCache: { token: string; expiresAt: number } | null = null;
  private refreshPromise: Promise<string> | null = null;
  private readonly BUFFER_MS = 30_000; // Refresh 30s trước khi expire

  async getToken(): Promise<string> {
    // Nếu token còn hạn (với buffer), trả về ngay
    if (this.tokenCache && Date.now() < this.tokenCache.expiresAt - this.BUFFER_MS) {
      return this.tokenCache.token;
    }

    // Nếu đang có refresh trong progress, chờ nó thay vì tạo request mới
    if (this.refreshPromise) {
      return this.refreshPromise;
    }

    // Khởi tạo refresh và lưu Promise để các caller khác có thể chờ
    this.refreshPromise = this.fetchNewToken().finally(() => {
      this.refreshPromise = null;
    });

    return this.refreshPromise;
  }
}
Pattern này đảm bảo rằng dù có bao nhiêu agent đồng thời cần token, chỉ có một request refresh được thực hiện tại một thời điểm. Tất cả các caller khác sẽ chờ cùng một Promise — không có race, không có duplicate requests, không có expired token slipping through.
Bài học #3: Trong hệ thống multi-agent, authentication token management cần được thiết kế với concurrency là first-class concern. “Works in testing” không có nghĩa là “works under load” khi race conditions chỉ xuất hiện ở một tỷ lệ nhỏ của concurrent requests. Hãy implement token refresh với explicit locking và buffer time đủ lớn để cover network latency.
Bức Tranh Toàn Cảnh: Khi Ba Bug Tương Tác Với Nhau
Điều làm cho tuần đó thực sự khó khăn không phải là ba bug riêng lẻ — mà là cách chúng che khuất lẫn nhau. Khi bạn đang debug Bug #2 (session corruption), triệu chứng đôi khi trông giống Bug #3 (OIDC failure) vì cả hai đều dẫn đến empty responses. Khi bạn fix Bug #1 (empty parameters), Bug #2 trở nên dễ tái hiện hơn vì bây giờ tool execution thực sự xảy ra và corrupt session state.
Đây là lý do tại sao layered debugging quan trọng hơn bao giờ hết trong hệ thống agent AI:
- Layer 1 — Network/Auth: Log toàn bộ HTTP request/response, bao gồm headers và timing. OIDC issues thường chỉ visible ở layer này.
- Layer 2 — Message Translation: Log conversation history trước và sau mỗi translation step. Schema mismatches sẽ xuất hiện ở đây.
- Layer 3 — Session State: Implement session health check endpoint cho phép bạn inspect conversation history của một agent đang chạy mà không cần kill process.
- Layer 4 — Model Behavior: Log response time, token count, và finish reason cho mọi LLM call. Response time dưới 200ms với token count bằng 0 là dấu hiệu rõ ràng của silent failure.
Khuyến Nghị Cho Production Systems
Sau một tuần đi qua địa ngục và trở về, đây là những gì chúng tôi sẽ làm khác đi nếu bắt đầu lại:
1. Test schema translation trước khi viết bất kỳ business logic nào. Tạo một test suite đơn giản gửi tool definitions qua toàn bộ stack và verify rằng schema đến model đúng format. Điều này mất 2 giờ và có thể tiết kiệm 2 ngày debug.
2. Implement “canary tool calls” trong integration tests. Một tool đơn giản với parameters đã biết, được gọi tự động sau mỗi deployment để verify rằng tool execution pipeline vẫn hoạt động end-to-end.
3. Sử dụng database-backed session storage ngay từ đầu. File-based JSON storage có vẻ đơn giản nhưng nó thiếu atomic writes, không có built-in validation, và khó monitor. Redis hoặc PostgreSQL với proper schema validation sẽ bắt được malformed messages trước khi chúng được persist.
4. Treat authentication token management như distributed systems problem. Ngay cả trong một Node.js process đơn, async concurrency tạo ra race conditions thực sự. Token refresh cần locking, buffering, và explicit error handling cho expiry edge cases.
5. Đừng tin tưởng “tương thích OpenAI” ở mức nominal. Mọi provider đều có quirks. Đọc source code của provider, không chỉ documentation. Trong trường hợp của chúng tôi, bug quan trọng nhất nằm trong một method có tên hoàn toàn rõ ràng — convertTools() — nhưng chúng tôi mất hai ngày mới nghĩ đến việc đọc implementation của nó.
Kết Luận
Hệ thống agent AI multi-layer không fail theo những cách dramatic. Chúng fail theo những cách subtle — empty parameters, silent empty responses, intermittent auth errors dưới load. Chính sự tinh tế này làm cho chúng nguy hiểm trong production: không có alarm nào kêu, không có exception nào được throw, chỉ có những kết quả ngày càng kém chất lượng hơn mà người dùng có thể quy cho “AI không hoàn hảo” thay vì một bug thực sự có thể fix được.
Bridge software giữa các AI ecosystem sẽ tiếp tục là một thực tế của enterprise AI deployment. Càng nhiều tổ chức route các frontier model qua internal infrastructure, càng có nhiều lớp translation cần phải đúng. Hy vọng rằng những bài học từ tuần đó của chúng tôi sẽ giúp bạn tránh được ít nhất một trong ba cái bẫy này.
Nếu bạn đang xây dựng hệ thống tương tự — đặc biệt là với GitLab AI Gateway, Vercel AI SDK, hoặc bất kỳ proxy layer nào giữa agent framework và LLM backend — hãy để lại comment hoặc liên hệ trực tiếp. Chúng tôi vẫn đang học, và những cuộc trò chuyện này là cách tốt nhất để cộng đồng cùng nhau tiến lên.