Microsoft BitNet: Mô Hình AI 1-Bit Thay Đổi Cuộc Chơi
Chi phí tính toán tăng vọt, nhu cầu năng lượng khổng lồ, và rào cản phần cứng ngày càng cao — đây là những thách thức đang đè nặng lên bất kỳ tổ chức nào muốn triển khai các mô hình ngôn ngữ lớn (LLM) trong thực tế. Chạy một mô hình như GPT-4 hay LLaMA 70B đòi hỏi hàng chục gigabyte VRAM, các GPU đắt tiền, và hóa đơn điện toán đám mây không hề nhỏ. Câu hỏi đặt ra là: liệu có cách nào để giữ nguyên chất lượng mô hình mà vẫn cắt giảm đáng kể chi phí và tài nguyên?
Microsoft Research đã trả lời câu hỏi đó bằng một công trình nghiên cứu táo bạo: BitNet — một kiến trúc Transformer cách mạng hóa cách lưu trữ trọng số mô hình bằng cách nén chúng xuống chỉ còn 1 bit. Kết quả là một mô hình AI mạnh mẽ hơn, nhanh hơn, tiết kiệm năng lượng hơn, và quan trọng nhất — có thể chạy ngay trên CPU của laptop thông thường. Đây không phải là một thí nghiệm học thuật xa vời; đây là một bước ngoặt thực sự trong kỷ nguyên AI hiệu quả.
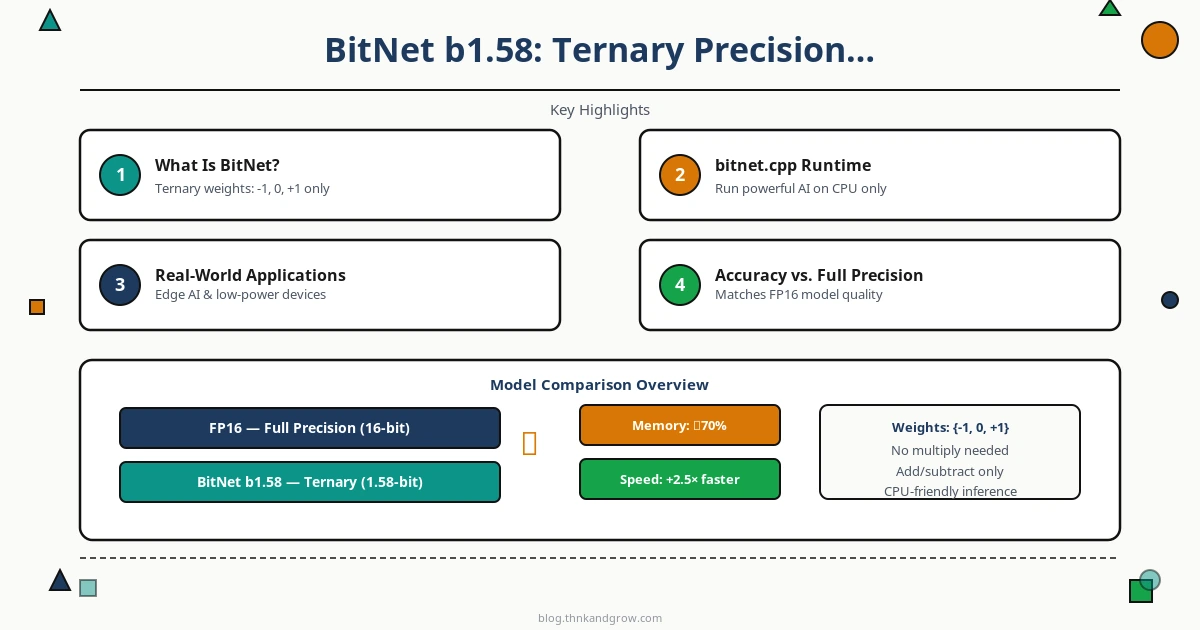
BitNet Là Gì? Ý Tưởng Cốt Lõi Đằng Sau LLM 1-Bit
Để hiểu BitNet, trước tiên cần nắm được cách các LLM truyền thống lưu trữ trọng số. Trong hầu hết các mô hình hiện đại, mỗi tham số (weight) được biểu diễn dưới dạng số thực dấu phẩy động với độ chính xác 16-bit (FP16) hoặc 32-bit (FP32). Một mô hình 7 tỷ tham số ở FP16 sẽ chiếm khoảng 14GB bộ nhớ — chưa kể bộ nhớ cần thiết cho quá trình suy luận (inference).
BitNet, được giới thiệu trong bài báo “BitNet: Scaling 1-bit Transformers for Large Language Models” năm 2023 bởi nhóm nghiên cứu của Microsoft gồm Hongyu Wang, Shuming Ma và Furu Wei, đề xuất một hướng tiếp cận hoàn toàn khác: thay vì dùng hàng chục bit cho mỗi trọng số, tại sao không chỉ dùng 1 bit?
Cụ thể, BitNet thay thế các lớp nn.Linear tiêu chuẩn trong kiến trúc Transformer bằng các lớp BitLinear tùy chỉnh. Trong các lớp này, mỗi trọng số chỉ có thể nhận một trong hai giá trị: +1 hoặc -1. Quá trình nhị phân hóa (binarization) này diễn ra trong suốt quá trình huấn luyện — không phải sau khi mô hình đã được huấn luyện xong — giúp mô hình học cách hoạt động hiệu quả với biểu diễn cực kỳ nén này ngay từ đầu.
Điểm mấu chốt: BitNet không phải là kỹ thuật nén mô hình sau huấn luyện. Đây là một kiến trúc mới được thiết kế từ nền tảng để hoạt động với trọng số 1-bit.
BitNet b1.58: Bản Nâng Cấp Ternary Đạt Ngang Độ Chính Xác Đầy Đủ
Nếu BitNet gốc là bước đột phá đầu tiên, thì BitNet b1.58 (công bố tháng 2/2024) mới là cột mốc thực sự thay đổi cuộc chơi. Phiên bản này mở rộng không gian giá trị trọng số từ 2 giá trị lên 3 giá trị: {-1, 0, +1} — gọi là biểu diễn ternary (tam phân).
Tên gọi “b1.58” xuất phát từ toán học: log₂(3) ≈ 1.58, nghĩa là mỗi trọng số ternary mang khoảng 1.58 bit thông tin. Con số nhỏ bé này lại mang đến hiệu quả vượt trội so với bản 1-bit thuần túy, vì giá trị 0 cho phép mô hình “tắt” các kết nối không cần thiết — một dạng sparsity tự nhiên.
Kết quả benchmark của BitNet b1.58 là điều khiến cộng đồng AI phải ngạc nhiên: mô hình đạt perplexity và hiệu suất downstream task tương đương với các mô hình FP16 cùng kích thước. Điều này có nghĩa là bạn gần như không mất gì về chất lượng, nhưng lại tiết kiệm được rất nhiều về tài nguyên.
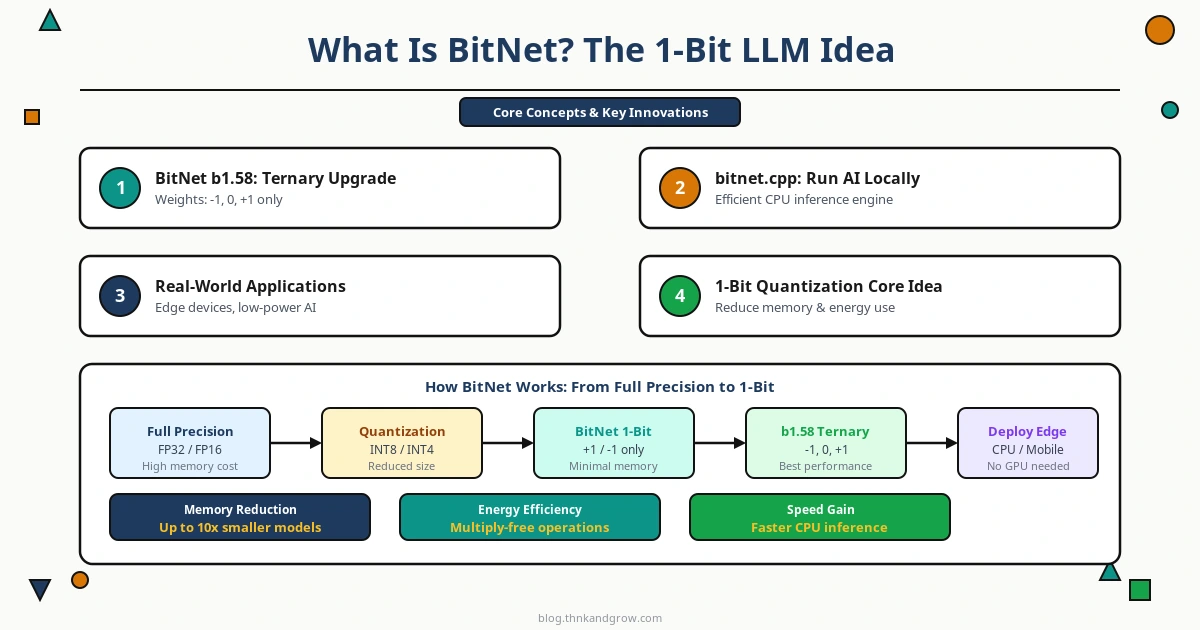
Lý do về mặt kỹ thuật rất thú vị: khi trọng số chỉ là {-1, 0, +1}, phép nhân ma trận (matrix multiplication) — vốn là phép tính tốn kém nhất trong mạng neural — có thể được thay thế hoàn toàn bằng phép cộng và trừ đơn giản. Không cần phép tính dấu phẩy động (floating-point). Điều này mở ra khả năng tối ưu hóa phần cứng cực kỳ sâu rộng, đặc biệt trên các chip không có đơn vị xử lý dấu phẩy động mạnh.
bitnet.cpp: Chạy AI Mạnh Mẽ Ngay Trên CPU Laptop
Nghiên cứu hay đến đâu cũng cần có công cụ thực tế để triển khai. Microsoft đã đáp ứng điều này bằng cách phát hành bitnet.cpp — framework inference mã nguồn mở chính thức, được tối ưu hóa đặc biệt cho việc chạy mô hình BitNet trên CPU.
Đây là điểm khác biệt quan trọng so với hầu hết các framework AI hiện nay vốn được thiết kế xoay quanh GPU. bitnet.cpp hỗ trợ cả kiến trúc ARM (Apple Silicon, Raspberry Pi, smartphone) và x86 (máy tính để bàn và server Intel/AMD thông thường), đồng thời tương thích với định dạng model của Hugging Face.
Các con số benchmark thực tế rất ấn tượng:
- Tốc độ: Nhanh hơn từ 1.37x đến 5.07x so với llama.cpp trên CPU ARM
- Tiết kiệm năng lượng: Giảm từ 55% đến 70% mức tiêu thụ điện trên phần cứng ARM
- Không cần GPU: Mô hình BitNet b1.58 3B có thể chạy mượt mà trên laptop CPU thông thường
Để bắt đầu nhanh với bitnet.cpp, bạn có thể clone repository và chạy inference chỉ với vài lệnh:
# Clone repository
git clone https://github.com/microsoft/BitNet.git
cd BitNet

# Cài đặt dependencies
pip install -r requirements.txt

# Tải model từ Hugging Face và chạy inference
python run_inference.py \
  --model microsoft/bitnet-b1.58-3B \
  --prompt "Xin chào, hãy giới thiệu về BitNet"
Ứng Dụng Thực Tế: BitNet Tạo Ra Tác Động Lớn Nhất Ở Đâu?
BitNet không chỉ là một bài toán học thuật — nó giải quyết những vấn đề thực tế mà các kỹ sư và kiến trúc sư hệ thống đang đối mặt hàng ngày.
Edge AI: LLM Trên Thiết Bị Nhúng
Khả năng chạy mô hình ngôn ngữ trên smartphone, Raspberry Pi, hay các thiết bị IoT mà không cần GPU là một bước tiến khổng lồ. Hãy tưởng tượng một trợ lý AI offline hoàn toàn trên điện thoại, xử lý ngôn ngữ tự nhiên mà không cần gửi dữ liệu lên cloud — vừa nhanh hơn, vừa bảo mật hơn, vừa hoạt động được ở nơi không có internet.
Giảm Chi Phí Cloud
Với các doanh nghiệp đang chạy khối lượng inference lớn trên Azure OpenAI hay các dịch vụ tương tự, BitNet có thể cắt giảm đáng kể chi phí. Ít tài nguyên tính toán hơn đồng nghĩa với hóa đơn thấp hơn — đặc biệt quan trọng khi số lượng token xử lý mỗi ngày lên đến hàng tỷ.
Green AI: AI Xanh Và Bền Vững
Microsoft đã cam kết trở thành carbon-negative vào năm 2030. BitNet là một công cụ kỹ thuật trực tiếp phục vụ mục tiêu này. Với mức tiêu thụ điện giảm đến 70%, việc triển khai BitNet ở quy mô lớn có thể tạo ra tác động môi trường tích cực rõ rệt — điều ngày càng quan trọng với các tổ chức có báo cáo ESG.
Dân Chủ Hóa AI
Không phải nhóm phát triển nào cũng có ngân sách để thuê GPU A100. BitNet mở ra cánh cửa cho các developer ở những khu vực khan hiếm GPU, các startup giai đoạn đầu, hay các nhóm nghiên cứu với ngân sách hạn chế để xây dựng ứng dụng AI thực sự có năng lực.
BitNet So Với Các Phương Pháp Quantization Khác
Khi nói đến việc thu nhỏ mô hình AI, BitNet không phải là cái tên duy nhất. Tuy nhiên, điểm khác biệt của nó là căn bản về triết lý, không chỉ là kỹ thuật.
Các phương pháp phổ biến như GPTQ và AWQ đều là kỹ thuật quantization sau huấn luyện (post-training quantization — PTQ). Nghĩa là bạn huấn luyện một mô hình FP16 đầy đủ trước, sau đó mới nén nó lại. Quá trình này không thể tránh khỏi một mức độ mất mát chất lượng nhất định vì mô hình chưa bao giờ “học” cách hoạt động với trọng số nén.
BitNet ngược lại: nó huấn luyện với quantization ngay từ đầu. Mô hình học cách biểu diễn tri thức trong không gian 1.58-bit trong suốt quá trình huấn luyện, dẫn đến chất lượng được bảo toàn tốt hơn nhiều.
- Apple MLX tập trung vào tối ưu hóa cho Apple Silicon — phần cứng chuyên biệt, không phải kiến trúc mô hình mới.
- Google Gemma quantization chủ yếu nhắm vào việc triển khai hiệu quả trên thiết bị Google, nhưng vẫn dựa trên nén sau huấn luyện.
- BitNet thiết kế lại kiến trúc, không chỉ nén mô hình có sẵn — đây là sự khác biệt cốt lõi.
Bắt Đầu Với BitNet Ngay Hôm Nay
Tin tốt là bạn không cần chờ đợi hay đầu tư lớn để bắt đầu thử nghiệm BitNet. Dưới đây là lộ trình thực tế:
- Bước 1: Truy cập github.com/microsoft/BitNet để xem tài liệu và mã nguồn chính thức.
- Bước 2: Tải các mô hình pre-trained từ Hugging Face (tìm kiếm
microsoft/bitnet) — đây là cách nhanh nhất để trải nghiệm mà không cần huấn luyện từ đầu. - Bước 3: Sử dụng bitnet.cpp cho CPU inference — đây là lựa chọn tối ưu về hiệu suất cho hầu hết người dùng.
- Bước 4 (nâng cao): Nếu muốn huấn luyện mô hình tùy chỉnh, PyTorch và Azure ML là môi trường được khuyến nghị.
- Tích hợp llama.cpp: Nếu bạn đã quen với hệ sinh thái llama.cpp, cộng đồng đã phát triển các integration cho phép chạy BitNet models trong framework quen thuộc này.
Tương Lai: Con Đường Phía Trước Của BitNet
Microsoft Research không dừng lại ở đây. Có nhiều hướng phát triển đang được tích cực nghiên cứu:
Các nhà nghiên cứu đang khám phá ứng dụng BitNet cho vision models và multimodal AI — mở rộng lợi ích của quantization 1-bit sang xử lý hình ảnh, video và các tác vụ đa phương thức. Nếu thành công, điều này có thể mang lại tác