Microsoft BitNet: Tương Lai Của Mô Hình AI 1-Bit
Cuộc Khủng Hoảng Năng Lượng AI Và Lời Giải Từ Microsoft
Trong vài năm gần đây, ngành công nghiệp AI đang đối mặt với một nghịch lý đáng lo ngại: các mô hình ngôn ngữ lớn (LLM) ngày càng mạnh hơn, nhưng chi phí vận hành chúng cũng tăng theo cấp số nhân. Một trung tâm dữ liệu phục vụ GPT-4 tiêu thụ lượng điện năng tương đương hàng nghìn hộ gia đình. Các doanh nghiệp vừa và nhỏ, các tổ chức nghiên cứu, và các nhà phát triển cá nhân ngày càng bị đẩy ra ngoài cuộc chơi AI chỉ vì không đủ khả năng chi trả cho hạ tầng GPU đắt đỏ.
Đây chính là bối cảnh mà Microsoft BitNet xuất hiện như một cuộc cách mạng thầm lặng nhưng đầy tiềm năng. Thay vì chấp nhận rằng AI mạnh phải đồng nghĩa với AI đắt tiền, nhóm nghiên cứu Microsoft Research đã đặt câu hỏi táo bạo: Điều gì sẽ xảy ra nếu chúng ta xây dựng các mô hình ngôn ngữ lớn chỉ với 1-bit trọng số? Kết quả là một hướng đi hoàn toàn mới — hiệu suất gần tương đương mô hình đầy đủ độ chính xác, nhưng chỉ tốn một phần nhỏ tài nguyên tính toán.
Microsoft BitNet Là Gì?
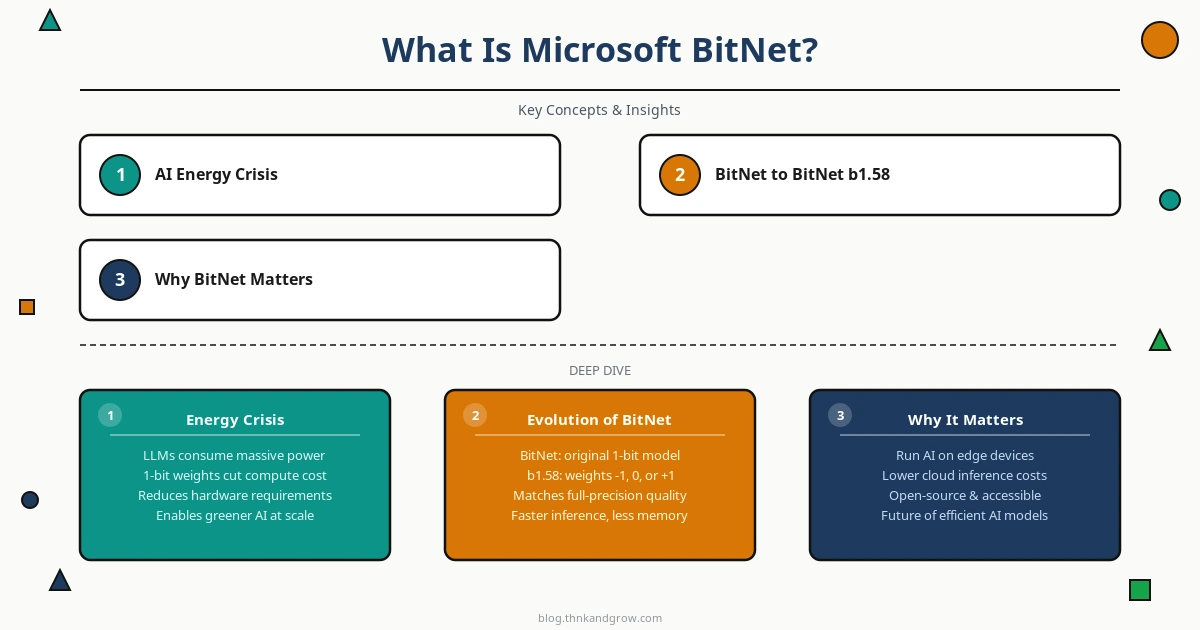
BitNet là một dự án nghiên cứu của Microsoft Research, tập trung vào việc xây dựng các mô hình ngôn ngữ lớn sử dụng trọng số 1-bit — tức là mỗi tham số trong mô hình chỉ có thể nhận một trong các giá trị nhị phân hoặc tam phân: -1, 0, hoặc +1.
Để hiểu tại sao điều này quan trọng, hãy so sánh với các mô hình truyền thống. Một LLM tiêu chuẩn như LLaMA hay GPT thường lưu trữ trọng số dưới dạng số thực dấu phẩy động 16-bit (FP16) hoặc 32-bit (FP32). Điều đó có nghĩa là mỗi tham số chiếm 2 đến 4 byte bộ nhớ. Với một mô hình 7 tỷ tham số, bạn cần ít nhất 14GB VRAM chỉ để tải mô hình — chưa kể tài nguyên cho quá trình suy luận.
BitNet thay đổi hoàn toàn phương trình này. Bằng cách giới hạn trọng số về các giá trị nhị phân hoặc tam phân, mô hình có thể thực hiện các phép tính ma trận phức tạp bằng các phép cộng và trừ đơn giản thay vì phép nhân dấu phẩy động tốn kém. Đây là sự thay đổi kiến trúc cơ bản, không phải chỉ là một kỹ thuật tối ưu hóa thông thường.
Dự án được dẫn dắt bởi các nhà nghiên cứu hàng đầu của Microsoft Research, bao gồm Furu Wei (Nhà nghiên cứu chính), Shuming Ma, và Li Dong — những tên tuổi quen thuộc trong cộng đồng nghiên cứu NLP toàn cầu.
Từ BitNet Đến BitNet b1.58: Hành Trình Tiến Hóa
Vào tháng 10 năm 2023, Microsoft Research công bố bài báo gốc “BitNet: Scaling 1-bit Transformers for Large Language Models”. Phát hiện cốt lõi của bài báo này rất đáng kinh ngạc: các mô hình 1-bit, khi được huấn luyện từ đầu ở quy mô đủ lớn, có thể đạt hiệu suất tương đương với các mô hình độ chính xác đầy đủ trên nhiều benchmark quan trọng.
Đến tháng 2 năm 2024, nhóm nghiên cứu tiếp tục công bố BitNet b1.58 với bài báo “The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits”. Phiên bản này giới thiệu khái niệm trọng số tam phân — thay vì chỉ dùng -1 và +1, mô hình có thêm giá trị 0. Con số 1.58 đến từ toán học: log₂(3) ≈ 1.58, nghĩa là mỗi trọng số tam phân cần khoảng 1.58 bit để biểu diễn.
Kết quả benchmark của BitNet b1.58 thực sự ấn tượng:
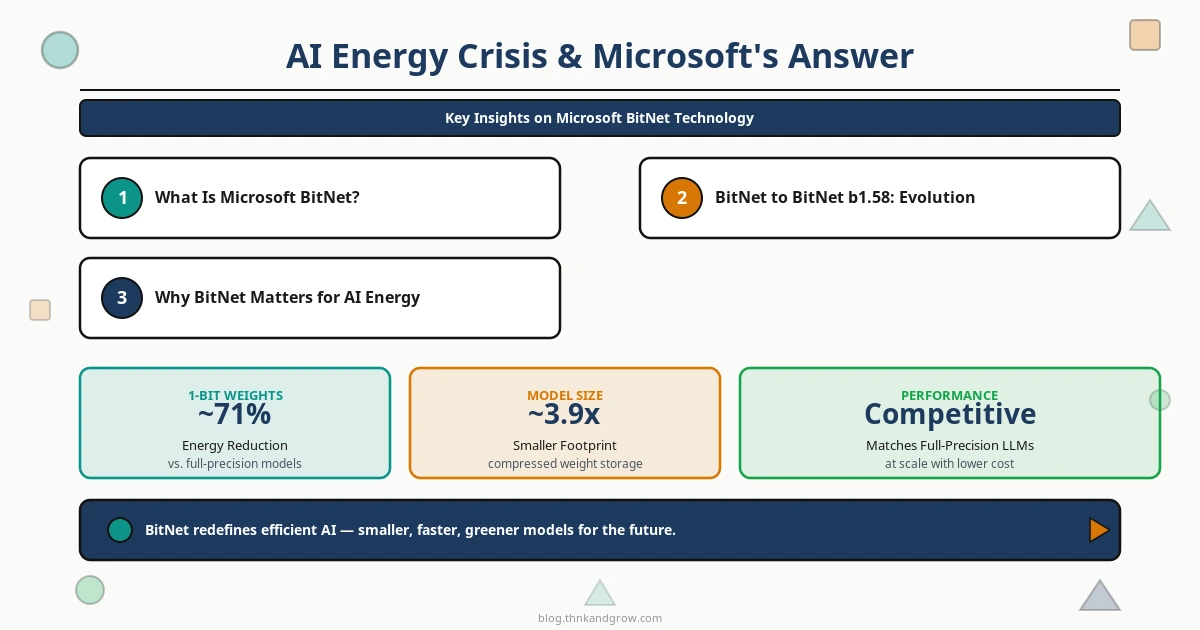
- 2.71x nhanh hơn trong quá trình suy luận so với LLaMA ở cùng quy mô tham số
- 3.55x ít bộ nhớ hơn — cho phép chạy các mô hình lớn hơn trên cùng phần cứng
- Đạt parity với FP16 về perplexity và các tác vụ downstream tại ngưỡng 3B+ tham số
- Tiêu thụ năng lượng thấp hơn đáng kể nhờ thay thế phép nhân ma trận bằng phép cộng
Cuối năm 2024, Microsoft tiếp tục giới thiệu BitNet a4.8, bổ sung thêm kích hoạt 4-bit (4-bit activations) song song với trọng số 1-bit, mở ra một biên giới mới trong việc tối ưu hóa toàn diện cả trọng số lẫn kích hoạt của mô hình.
Tại Sao BitNet Quan Trọng Với Ngành AI?
Tầm quan trọng của BitNet vượt xa phạm vi một bài báo nghiên cứu học thuật. Nó chạm đến những vấn đề cốt lõi mà ngành AI đang phải đối mặt.
Giải Quyết Khủng Hoảng Năng Lượng AI
Các trung tâm dữ liệu phục vụ LLM đang tiêu thụ điện năng ở mức đáng báo động. Theo một số ước tính, một truy vấn ChatGPT tốn gấp 10 lần năng lượng so với một tìm kiếm Google thông thường. BitNet tấn công trực tiếp vào gốc rễ của vấn đề này: bằng cách loại bỏ các phép nhân dấu phẩy động tốn kém, mỗi lần suy luận tiêu thụ ít năng lượng hơn đáng kể, giúp giảm dấu chân carbon của AI một cách thực chất.
Dân Chủ Hóa AI
Với BitNet, một mô hình ngôn ngữ mạnh mẽ có thể chạy trực tiếp trên điện thoại thông minh, thiết bị IoT, laptop không có GPU chuyên dụng, thậm chí trên các vi điều khiển nhúng. Điều này mở ra khả năng triển khai AI ở những nơi mà trước đây không thể tưởng tượng được — từ xe ô tô tự lái đến thiết bị y tế cầm tay ở vùng sâu vùng xa.
Giảm Chi Phí Doanh Nghiệp
Đối với các doanh nghiệp đang triển khai AI trên Azure hoặc hạ tầng on-premises, BitNet có thể cắt giảm chi phí tính toán một cách đáng kể. Thay vì cần một cluster GPU đắt tiền, nhiều ứng dụng AI doanh nghiệp có thể chạy trên CPU thông thường — một sự thay đổi kinh tế học hoàn toàn.
Phù Hợp Với Chiến Lược AI Của Microsoft
BitNet không phải là dự án nghiên cứu đơn lẻ. Nó phù hợp hoàn hảo với chiến lược AI toàn diện của Microsoft, bao gồm quan hệ đối tác với OpenAI, nền tảng Azure AI, và dòng sản phẩm Phi — các mô hình ngôn ngữ nhỏ (SLM) mà Microsoft đang tích cực phát triển để cạnh tranh trong phân khúc AI hiệu quả.
Hệ Sinh Thái Công Cụ Và Framework BitNet
Một trong những điểm mạnh của BitNet là hệ sinh thái công cụ ngày càng phong phú xung quanh nó.
bitnet.cpp — Framework Chính Thức
Microsoft đã phát hành bitnet.cpp — một framework suy luận viết bằng C++, được tối ưu hóa đặc biệt cho các mô hình BitNet. Điểm nổi bật:
- Hỗ trợ suy luận chỉ dùng CPU — không cần GPU
- Tối ưu hóa cho kiến trúc x86 (AVX2) và ARM (NEON)
- Đạt tốc độ nhanh hơn từ 1.37x đến 5.07x trên CPU ARM so với các framework thông thường
- Mã nguồn mở tại
github.com/microsoft/BitNet
Hệ Sinh Thái Microsoft Liên Quan
BitNet tích hợp tốt với các công cụ Microsoft hiện có:
- ONNX Runtime — Engine suy luận đa nền tảng, tương thích với BitNet
- DeepSpeed — Thư viện huấn luyện phân tán, hỗ trợ các kỹ thuật tối ưu hóa bộ nhớ
- Olive — Bộ công cụ tối ưu hóa mô hình của Microsoft
- Azure Machine Learning — Nền tảng đám mây cho huấn luyện và triển khai
Cộng Đồng Mã Nguồn Mở
Cộng đồng AI đã nhanh chóng đón nhận BitNet. llama.cpp — engine suy luận phổ biến nhất trong cộng đồng mã nguồn mở — đã bổ sung hỗ trợ BitNet. Các mô hình BitNet đang được host trên Hugging Face, và framework PyTorch được sử dụng làm nền tảng huấn luyện chính.
Điểm quan trọng cần nhấn mạnh: BitNet khác căn bản với các phương pháp lượng tử hóa sau huấn luyện như GPTQ hay AWQ. Trong khi GPTQ và AWQ nén các mô hình đã được huấn luyện, BitNet được huấn luyện từ đầu với kiến trúc 1-bit — đây là lý do tại sao nó đạt hiệu quả vượt trội hơn.
Các Trường Hợp Ứng Dụng Thực Tế
Edge AI Và Thiết Bị Di Động
Đây là ứng dụng hấp dẫn nhất của BitNet. Hãy tưởng tượng một trợ lý AI hoàn toàn chạy offline trên điện thoại của bạn, không cần gửi dữ liệu lên đám mây. Hoặc một hệ thống chẩn đoán y tế nhúng trong thiết bị cầm tay tại các vùng không có internet. BitNet biến những kịch bản này thành hiện thực khả thi.
Suy Luận Đám Mây Tiết Kiệm Chi Phí
Các doanh nghiệp đang chạy AI trên Azure có thể giảm đáng kể chi phí compute bằng cách chuyển sang mô hình BitNet — phục vụ nhiều yêu cầu hơn trên cùng một đơn vị tính toán, đồng thời giảm hóa đơn điện toán đám mây hàng tháng.
AI Doanh Nghiệp On-Premises
Các ngành như y tế, tài chính, và pháp lý thường có yêu cầu nghiêm ngặt về bảo mật dữ liệu, không thể gửi thông tin nhạy cảm lên đám mây. BitNet cho phép triển khai AI mạnh mẽ hoàn toàn on-premises trên phần cứng CPU thông thường — không cần đầu tư vào GPU đắt tiền.
Nghiên Cứu Và Giáo Dục
Các trường đại học và viện nghiên cứu nhỏ không cần phải từ bỏ việc thực nghiệm với LLM chỉ vì thiếu ngân sách GPU. BitNet mở ra cánh cửa cho nghiên cứu AI dân chủ hơn, nơi một chiếc laptop thông thường có thể trở thành phòng thí nghiệm AI đủ năng lực.
Thực Hành Tốt Nhất Khi Làm Việc Với BitNet
Mẹo Huấn Luyện
- Sử dụng BitLinear layers như các lớp thay thế trực tiếp cho lớp Linear thông thường trong PyTorch
- Áp dụng absmax quantization cho kích hoạt — kỹ thuật này giúp duy trì chất lượng mô hình
- Huấn luyện từ đầu — đừng cố gắng lượng tử hóa mô hình đã huấn luyện sẵn, đây là sự khác biệt kiến trúc cốt lõi
- Cân nhắc sử dụng learning rate cao hơn so với huấn luyện transformer thông thường
Mẹo Suy Luận
- Dùng bitnet.cpp cho triển khai CPU — đây là lựa chọn tối ưu nh